SEO pro e-shopy: chyby v kategoriích, filtrech a duplicitách, které vám potichu berou pozice
Představte si e-shop se dvěma tisíci produktů, o kterém Google eviduje přes sto tisíc adres. Většinu z nich vyrobily filtry, řazení a stránkování. Robot pak tráví čas na variantách téže kategorie a nové zboží objeví pozdě. Prošli jsme dokumentaci Googlu i Seznamu, změřili výchozí nastavení jedné z nejrozšířenějších českých platforem a sepsali, jak kategorie, filtry a duplicity nastavit, aby ve výsledcích hledání stály ty správné stránky.
Podle Eurostatu nakoupilo v roce 2025 přes internet 83,67 % Čechů ve věku 16 až 74 let, průměr EU byl 73,56 %. Obrat českých e-shopů odhadují APEK a Heureka za rok 2025 na 206 miliard korun. Konkurence ve výsledcích hledání je proto velká a o pozicích často rozhoduje technika: kolik adres e-shop vyrábí a které z nich vyhledávači dovolí procházet.
V Česku navíc nestačí myslet jen na Google. Seznam měl za posledních 12 měsíců podle StatCounteru 12,55 % návštěv z vyhledávačů, v srpnu 2026 dokonce 15,79 %. A v některých věcech se chová jinak, třeba ignoruje hlavičku X-Robots-Tag. Kde se oba vyhledávače liší, upozorníme na to.
- Google81,06 %
- Seznam12,55 %
- Bing4,34 %
Podíl návštěv z vyhledávačů na webech s měřicím kódem StatCounteru, všechna zařízení, průměr 12 měsíců. Nejde o podíl vyhledávacích dotazů. Zdroj: StatCounter Global Stats.
Článek se zaměřuje na to, čím se SEO optimalizace e-shopu liší od běžného webu: kategorie, filtry, řazení, stránkování, varianty produktů a duplicitní obsah. Obecné principy SEO pro rok 2026 najdete v článku SEO v roce 2026: co opravdu funguje.
01Kategorie jsou vaše nejsilnější vstupní stránky
Na obecný dotaz typu „pánské běžecké boty“ Google i Seznam obvykle ukazují výpisy kategorií, detail jednoho produktu jen výjimečně. Kategorie proto musí odpovídat tomu, jak lidé hledají, ne tomu, jak máte uspořádaný sklad. Když dodavatel třídí zboží na „Obuv M“ a „Obuv W“, zákazník přesto napíše „pánské boty“ a „dámské boty“.
Názvy kategorií, nadpisy H1 a titulky pište v tvaru, který lidé skutečně zadávají. U kategorií je to obvykle první pád množného čísla. Všechny pády do textu cpát nemusíte: Seznam podle své nápovědy rozšiřuje dotaz o základní a odvozené tvary slov, zadaný tvar ale upřednostní. Diakritiku doplňuje sám.
Důležitost stránky Google neodvozuje ze struktury adres, ale z odkazů. Podle jeho dokumentace platí, že čím víc interních odkazů na stránku vede, tím je v rámci webu důležitější. Doporučuje hierarchii menu, kategorie, podkategorie, produkty a připomíná, že Googlebot nezkouší zadávat dotazy do vyhledávacího pole. Produkt, na který nevede žádný odkaz z kategorie, tak může zůstat neobjevený. Víc o stavbě hierarchie píšeme v článku Jak vytvořit strukturu webu.
- Titulek a H1: hlavní dotaz na začátku, bez opakování názvu e-shopu v nadpisu.
- Krátký úvod nad výpisem: dvě až tři věty, které pomohou vybrat. Dlouhý text pod stránkováním čte málokdo.
- Odkazy na podkategorie: viditelné nad produkty, ne schované jen v rozbalovacím menu.
- Každá kategorie má vlastní smysl: nevytvářejte dvě kategorie, které ukazují skoro stejné zboží.
02Filtry vyrobí víc adres, než kolik máte zboží
Vezměte kategorii s pěti filtry (značka, barva, velikost, materiál, cena) a u každého deseti hodnotami. Pokud zákazník smí z každého filtru vybrat jednu hodnotu nebo žádnou, existuje 11 × 11 × 11 × 11 × 11 = 161 051 kombinací. Se čtyřmi způsoby řazení je to 644 204 adres. Pořád bez stránkování, bez výběru více hodnot jednoho filtru a bez prohozeného pořadí parametrů. A to jde o jedinou kategorii.
Google tomu říká fasetová navigace a v dokumentaci varuje, že nejběžnější řešení přes parametry v adrese může vytvořit nekonečný prostor adres. Robot pak prochází zbytečné stránky a na nové produkty mu zbývá méně času. Už v prosinci 2024 Gary Illyes z Googlu napsal, že fasetová navigace je zdaleka nejčastější příčinou nadměrného procházení, které majitelé webů Googlu hlásí. Na začátku roku 2026 to v podcastu Search Off the Record vyčíslil:
- Fasetová navigace (filtry)50 %
- Akční parametry (do košíku, oblíbené)25 %
- Nepotřebné parametry (utm, session ID)10 %
- Pluginy a kalendáře5 %
- Ostatní chyby v adresách2 %
Přibližné podíly z hlášení, která Googlu poslali provozovatelé webů přes formulář, ne ze všech webů. Zbývajících 8 % Gary Illyes nerozepsal. Zdroj: přepis Search Off the Record, 3. 2. 2026.
Čtvrtina hlášení připadá na akční parametry. Typicky jde o „Přidat do košíku“ nebo „Do oblíbených“ udělané jako odkaz na adresu s parametrem, a ne jako tlačítko. Každý takový odkaz u produktu zdvojí počet adres, které robot může najít. Tyhle adresy do indexu nepatří nikdy.
Filtry přitom nejsou chyba. Zákazníci je potřebují a i velké e-shopy jich mívají spíš málo než moc. Baymard Institute prověřil 343 velkých amerických a evropských e-shopů:
- Nenabízí všechna 4 základní řazení (mobil)69 %
- Nenabízí všechna 4 základní řazení (počítač)68 %
- Nemá všech 5 základních filtrů51 %
- Chybí přehled vybraných filtrů20 %
- Nejde vybrat víc hodnot filtru14 %
Základní filtry podle Baymardu: cena, hodnocení, barva, velikost a značka. Benchmark 343 velkých e-shopů z USA a Evropy, článek aktualizován 9. 9. 2025. Malé e-shopy v něm nejsou. Zdroj: Baymard Institute.
Úkol tedy nezní „méně filtrů“. Filtry nechte lidem a robotům otevřete jen ty kombinace, které mají ve výsledcích hledání co dělat.
03Které kombinace filtrů pustit do indexu
Některé filtrované výpisy si vlastní stránku zaslouží. „Pánské běžecké boty Nike“ nebo „dámské zimní bundy XL“ lidé hledají a obecná kategorie na ně neodpovídá přesně. Většina kombinací ale hledanost nemá a vypadá jako kategorie s o něco kratším seznamem.
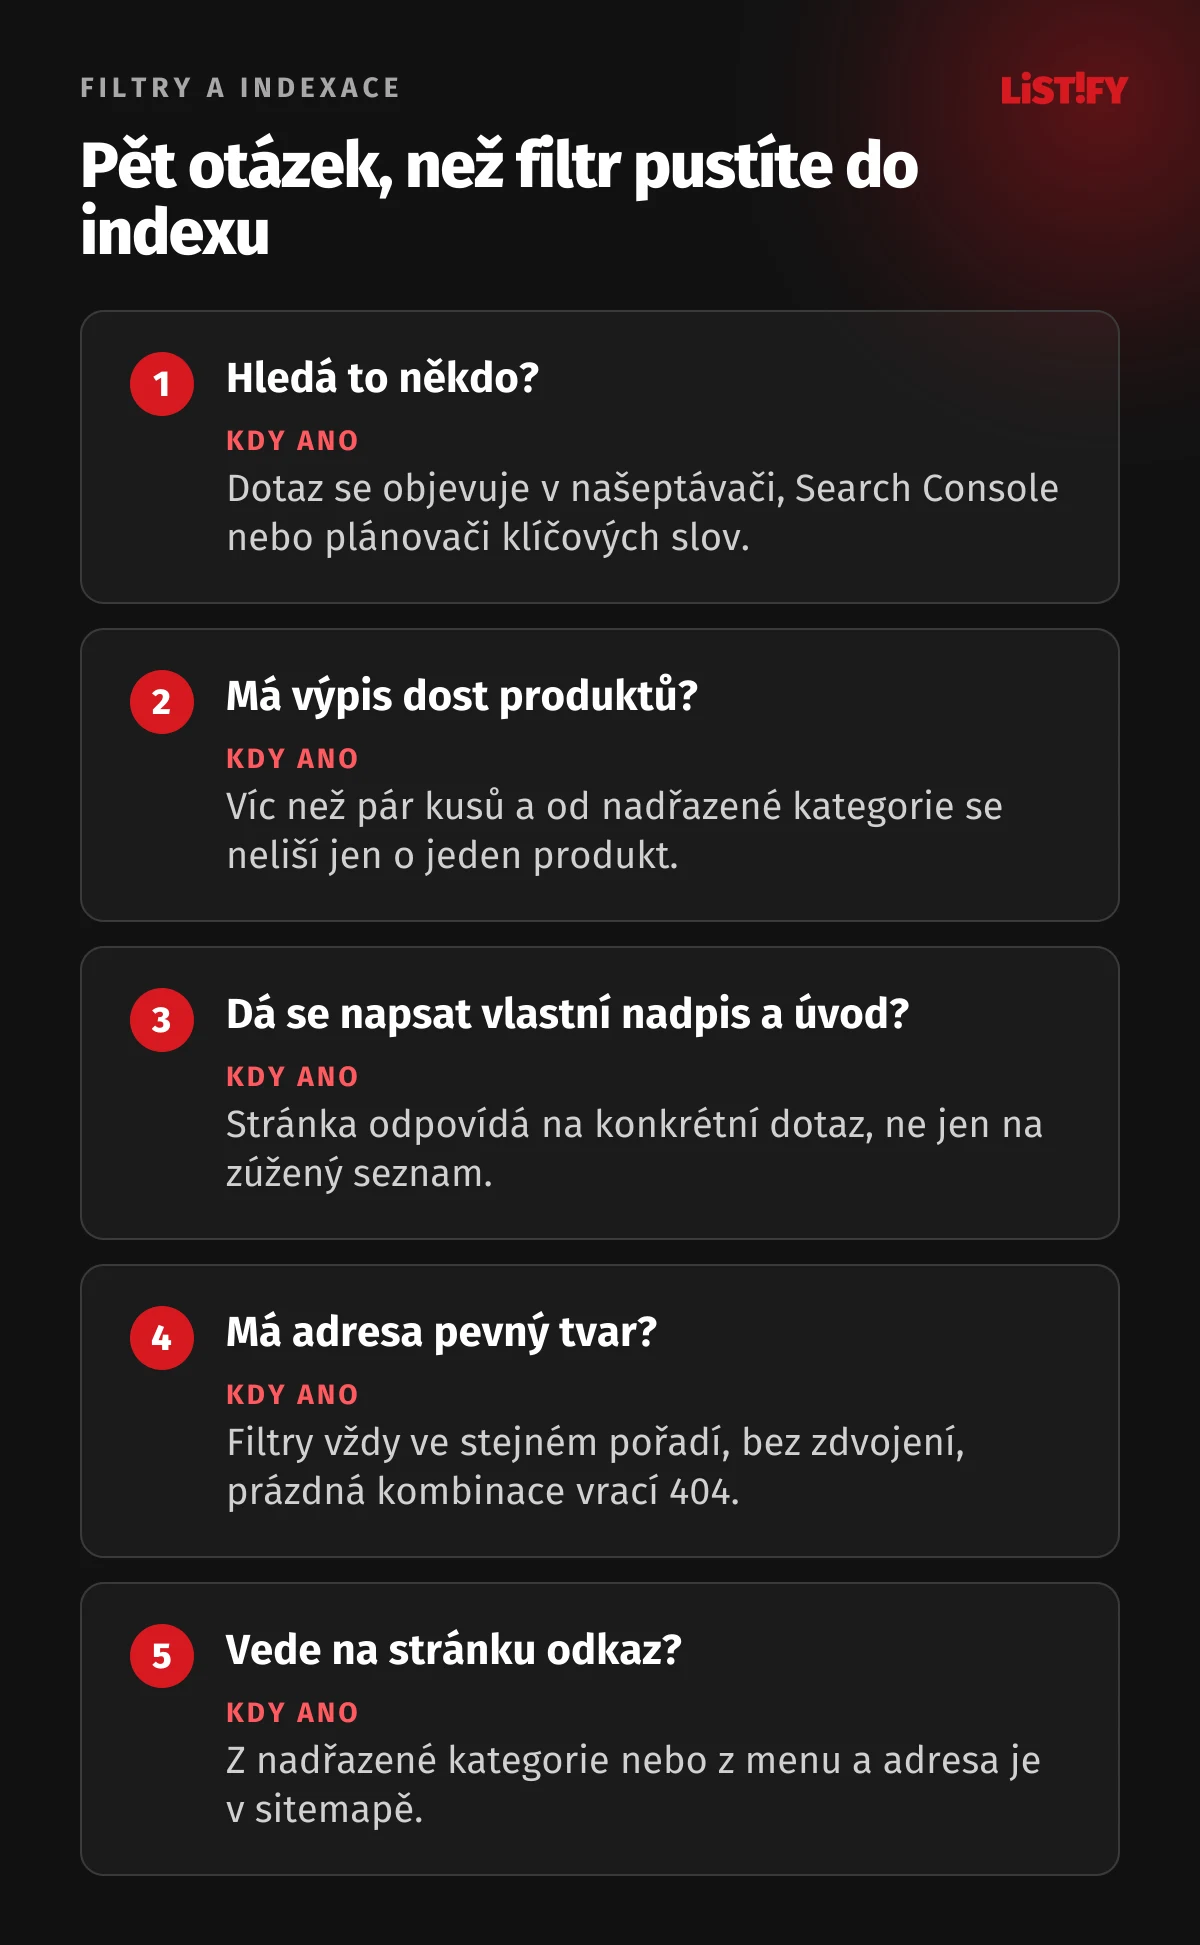
Pro kombinace, které indexovat chcete, radí Google oddělovat parametry standardním znakem &, držet filtry v adrese vždy ve stejném pořadí a pro kombinaci bez výsledků vracet stavový kód 404. Stejně má skončit i adresa se zdvojeným filtrem, nesmyslnou kombinací nebo neexistující stránkou výpisu. Přesměrování na obecnou chybovou stránku Google výslovně nedoporučuje. Kombinace, kterou do indexu pouštíte, pak dostane vlastní nadpis, úvod, kanonický odkaz sama na sebe, místo v sitemapě a odkaz z nadřazené kategorie.
Ostatní kombinace robotům zavřete. Google na prvním místě doporučuje zakázat procházení filtrů v souboru robots.txt, nebo filtry zapisovat do části adresy za znakem #, kterou vyhledávače při procházení obvykle ignorují. Kanonický odkaz a atribut nofollow jsou podle něj dlouhodobě méně účinné. Nofollow navíc funguje, jen když ho mají všechny odkazy na danou adresu, včetně těch z cizích webů.
Na Shoptetu jsou filtry ve výchozím stavu neindexovatelné a indexovatelnou stránku z kombinace parametrů vytvoří až doplněk Pokročilé SEO jako parametrickou kategorii. Nabízí kombinace až čtyř parametrů a sám předem zaškrtne všechny, které obsahují aspoň jeden produkt. Tady je potřeba škrtat. Kombinace s jedním produktem a nulovou hledaností přidá do sitemapy jen další tenkou stránku. Shoptet sám upozorňuje, že automatické názvy typu „M fialová bavlna“ nejsou pro češtinu vhodné.
Že se správně vybrané filtry vyplatí, ukazuje případová studie agentury eVisions pro autobazar AutoPalace. Po zpřístupnění filtrů s vlastními nadpisy a texty vzrostly podle agentury prokliky z Googlu na dotazy bez názvu značky meziročně o 308 % (březen až květen 2023). Jde o vlastní data agentury bez kontrolní skupiny, berte je proto jen jako ilustraci.
04Řazení, stránkování a tlačítko „Načíst další“
Řazení podle ceny nebo oblíbenosti ukazuje stejné zboží v jiném pořadí. Do indexu nepatří. Google v dokumentaci ke stránkování připouští obě cesty, noindex i blokaci v robots.txt. U velkých katalogů ale radí robots.txt, protože stránku s noindexem musí robot nejdřív stáhnout, aby značku uviděl, a tím plýtvá kapacitou procházení. Google tím míní hlavně weby s víc než milionem stránek, které se mění zhruba jednou týdně, weby s víc než 10 000 stránkami, které se mění denně, a weby, kde Search Console hlásí velkou část adres jako „Objeveno, momentálně neindexováno“. Sám dodává, že jde o hrubý odhad. Menšímu e-shopu obvykle stačí noindex.
Stránkování funguje jinak. Druhá a další strana výpisu obsahují jiné produkty, takže podle Googlu potřebují:
- vlastní adresu, třeba
?page=2nebo/strana-2/, nikdy jen část za znakem #, - vlastní kanonický odkaz, ne odkaz na první stranu,
- obyčejný odkaz
<a href>na další stranu. Na tlačítko „Načíst další“ robot neklikne.
Značky rel="next" a rel="prev" Google už nepoužívá. Jiné vyhledávače je podle něj používat můžou, takže je mazat nemusíte, jen v Googlu nepomůžou. Nápověda Seznamu stránkování neřeší vůbec.
Pozor na stránky, které neexistují. Na oficiálním demu Shoptetu (classic.shoptet.cz) jsme 30. 9. 2026 otevřeli kategorii Dekorace s osmi produkty na adrese /dekorace/strana-99/. Vrátila stavový kód 200, značku index a prázdný výpis. Google přitom pro neexistující stránkování doporučuje kód 404. Pokud na takovou adresu nevede odkaz, robot ji nenajde a nic se neděje. Ve vlastním e-shopu si to ale ověřte, nastavení se může lišit.
05Odkud se v e-shopu bere duplicitní obsah
Nejdřív uklidnění: za běžné duplicity v e-shopu žádná penalizace nehrozí. Google to napsal už v roce 2008 a v aktuální dokumentaci uvádí, že určitá míra duplicitního obsahu je normální a neporušuje jeho pravidla. Duplicitní adresy seskupí a vybere z nich jednu. Problém je jinde: signály se rozdělí mezi víc adres a do výsledků se může dostat jiná verze, než chcete. Seznam slovo „penalizace“ používá, ale jen u duplicitních domén se stejným obsahem, ne u duplicit uvnitř jednoho webu.
| Zdroj duplicity | Příklad | Řešení |
|---|---|---|
| Produkt ve více kategoriích | /boty/bezecke/nike-pegasus a /akce/nike-pegasus | Jedna adresa produktu nezávislá na kategorii, jinak kanonický odkaz nebo 301 |
| Řazení a filtry | /boty/?order=price | noindex, nebo zákaz procházení v robots.txt (ne obojí najednou) |
| Sledovací parametry | /boty/?utm_source=newsletter, ?gclid= | Kanonický odkaz na čistou adresu, interně na ně neodkazovat |
| Protokol, www a lomítko | http:// proti https://, /boty proti /boty/ | Jedna verze a 301 ze všech ostatních |
| Velká a malá písmena | /Boty/ proti /boty/ | Sjednotit, ostatní tvary přesměrovat nebo vracet 404 |
| Varianty produktu | /tricko?barva=cervena | Vlastní adresa varianty, kanonická adresa bez volitelného parametru |
| Popisy od dodavatele | Stejný text na desítkách e-shopů | Vlastní popis aspoň u nejprodávanějšího zboží |
| Česká a slovenská verze | Slovenský e-shop s českými popisy | Přeložit hlavní obsah do slovenštiny, hreflang, kanonický odkaz ve stejném jazyce |
Produkt ve více kategoriích řeší Seznam v optimalizačním minimu výslovně: pokud možno nevytvářet víc adres pro stejný obsah, a když už vzniknou, přesměrovat je na jednu hlavní nebo použít kanonický odkaz. Nejčistší je adresa produktu bez cesty kategorie. Nemusíte pak nic kanonizovat a produkt můžete přesouvat mezi kategoriemi bez přesměrování.
Popisy od dodavatele penalizaci nezpůsobí, ale nepomůžou vám. Google v článku z roku 2008 zmiňuje affiliate weby, které přebírají stejné výpisy jako Amazon, a ptá se, jak by ho s identickým obsahem mohly předběhnout. E-shop s texty od dodavatele má stejný problém proti každému většímu konkurentovi se stejným popisem. Vlastní popis s tím, co zákazník opravdu řeší (rozměry, rozdíly mezi modely, zkušenosti z reklamací), napište aspoň u zboží, které dělá většinu tržeb. Pro srovnávače to nevadí: Heureka pro Marketplace chce ve feedu stejný popis jako na webu a Zboží.cz doporučuje popis dlouhý 250 až 1 024 znaků bez reklamních sloganů.
U variant rozhodněte, jestli má každá barva nebo velikost vlastní stránku. Google doporučuje pro každou variantu samostatnou adresu (cestou nebo parametrem) a při volitelném parametru dát jako kanonickou adresu tu bez něj. Varianty rozlišené jen částí za znakem # považuje za jednu stránku. Na to spoléhá i Heureka, která pro varianty na jedné stránce doporučuje právě fragmenty #.
06Canonical, noindex, robots.txt: kdy použít co
Robots.txt, noindex a kanonický odkaz dělají každý něco jiného a nejvíc chyb vzniká, když se zamění nebo zkombinují.
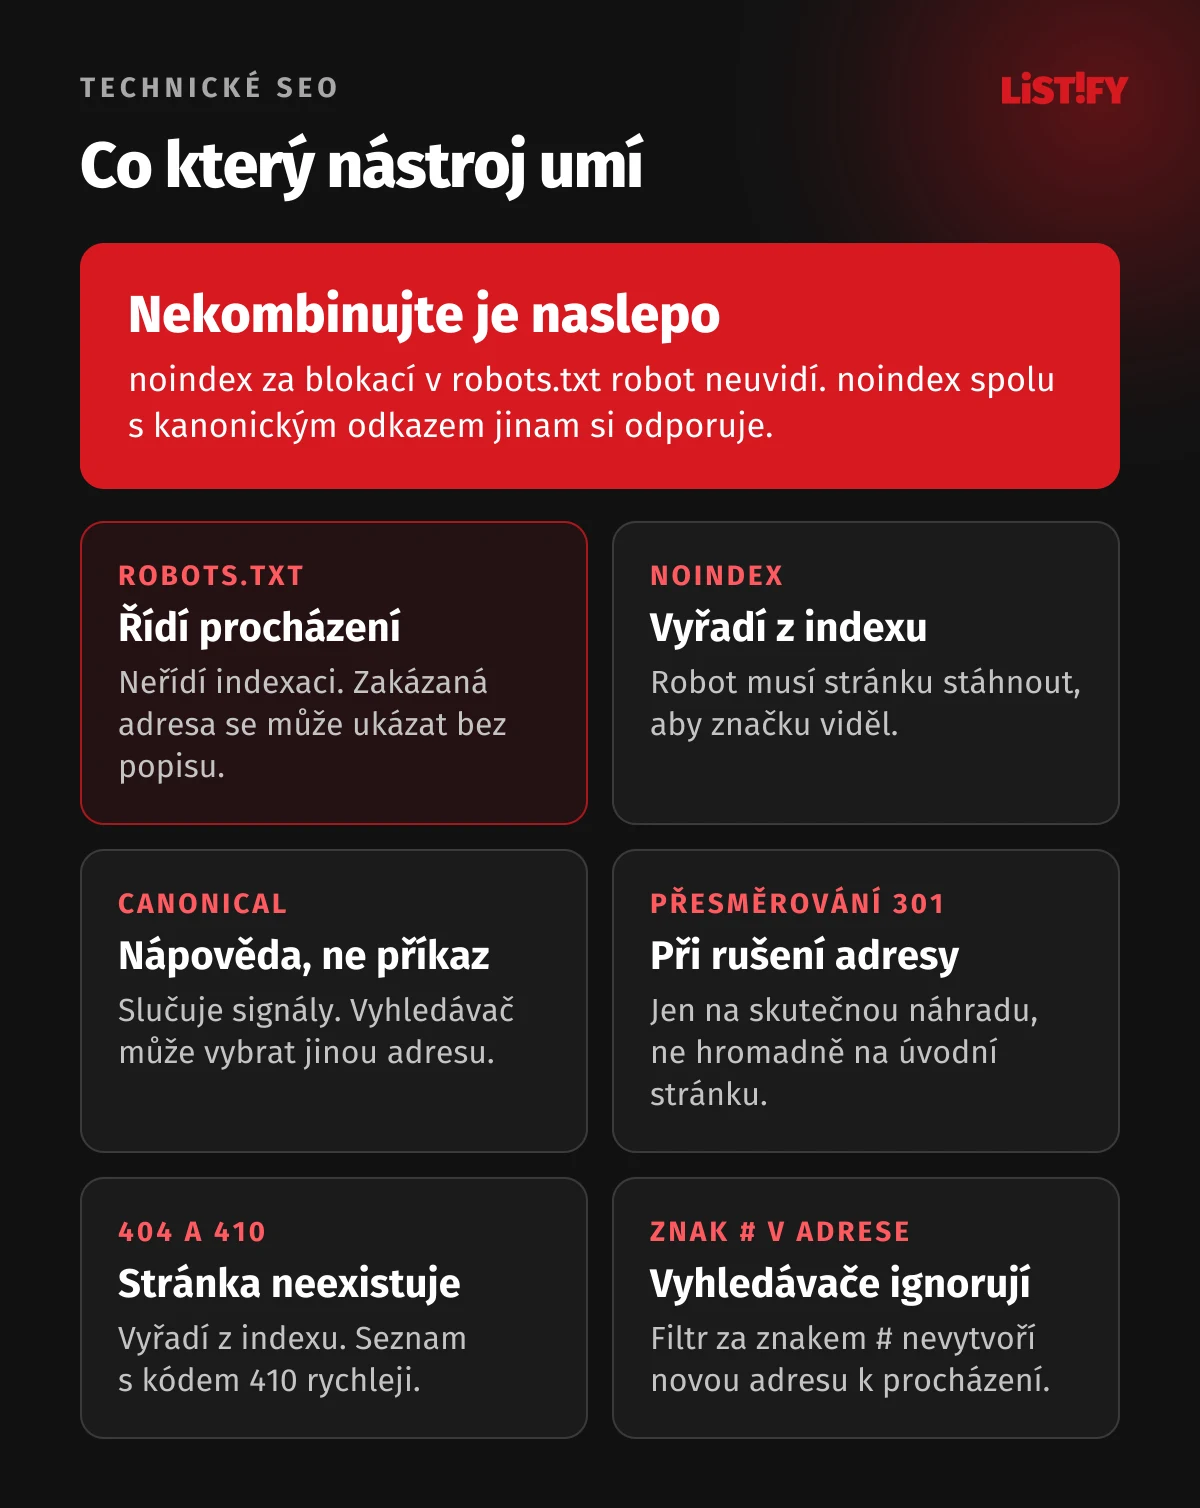
Kanonický odkaz (kanonická URL) je nápověda, ne příkaz. Google to píše doslova a vybrat si může jinou adresu. Podle návodu k řešení problémů s kanonizací může Google stránky držet v jednom shluku duplicit ještě až dva týdny po opravě. Seznam kanonický odkaz nepřijme, když mu stránky nepřijdou dost podobné. Pokud ho přijme, chápe ho interně skoro jako přesměrování 301.
robots.txt neřídí indexaci. Zakázaná adresa se podle Googlu může objevit ve výsledcích, jen bez popisu, pokud na ni vedou odkazy. V Search Console ji pak najdete ve stavu „Indexováno, ačkoli je přístup blokován souborem robots.txt“.
noindex za blokací v robots.txt nefunguje. Robot stránku nestáhne, a značku proto neuvidí. Píše to Google i Seznam. Přitom jde o častou kombinaci „pro jistotu“. Najdete ji třeba na demu Shoptetu, kde má řazení ?order=price značku noindex a zároveň je zakázané v robots.txt. Když na takové adresy nevedou odkazy zvenku, obvykle to nevadí. Jestli ale už v indexu jsou, blokace v robots.txt jim cestu ven zavře.
noindex s kanonickým odkazem jinam si odporují. Jedním signálem říkáte „neindexuj mě“, druhým „přenes moje signály jinam“. Google v dokumentaci ke kanonizaci noindex pro výběr kanonické adresy výslovně nedoporučuje. Zvolte jedno.
Kde se Google a Seznam liší:
| Situace | Seznam | |
|---|---|---|
| Hlavička X-Robots-Tag | Řídí se jí | Ignoruje ji, noindex musí být v HTML |
| Kanonický odkaz sám na sebe | Doporučuje ho | Ignoruje ho, neškodí |
| Kanonický odkaz na jinou stránku | Nápověda, může vybrat jinak | Nepřijme při malé podobnosti, jinak skoro jako 301 |
| 404 proti 410 | Všechny chyby 4xx kromě 429 bere stejně | 410 vyřadí stránku podstatně rychleji |
| Sitemapa | Search Console nebo robots.txt | Musí být uvedená v robots.txt |
| Rel next a prev | Nepoužívá | Nápověda o nich mlčí |
Kdo ještě hledá v Search Console nastavení parametrů, nenajde ho. Google nástroj Parametry URL zrušil v roce 2022 s tím, že užitečné bylo jen asi 1 % nastavení. Náhradou je robots.txt a správně postavené adresy.
07Vyprodané a zrušené zboží, prázdné kategorie
Dočasně vyprodaný produkt stránku nemaže. Google radí nechat ji dostupnou, označit zboží jako nedostupné a upravit strukturovaná data. Nástroj na odstranění adres k tomu nepoužívejte. Zákazník uvidí, co se děje, a stránka si drží pozice pro chvíli, kdy zboží znovu naskladníte.
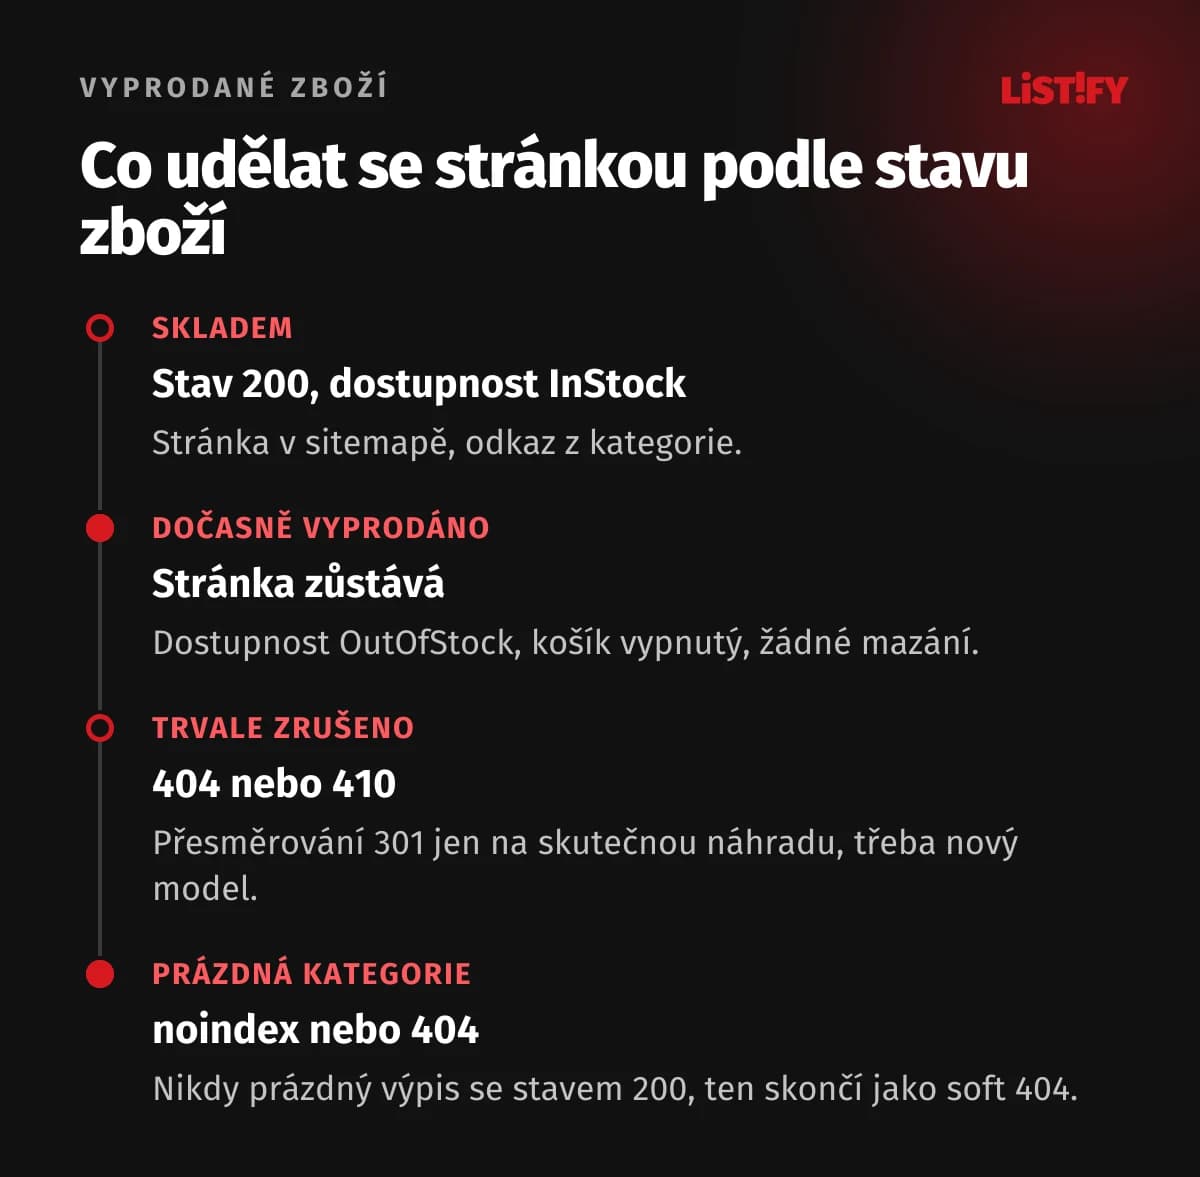
Trvale zrušený produkt má vracet 404 nebo 410. Google mezi nimi nerozlišuje, Seznam podle nápovědy vyřadí adresu s kódem 410 podstatně rychleji. Přesměrování 301 dává smysl, jen když existuje skutečná náhrada, třeba nový model téže řady. Hromadné přesměrování na hlavní stránku signály podle Seznamu nepřenese.
Prázdná kategorie by podle Googlu měla dostat noindex, a pokud ji e-shop sám skryje z navigace, klidně 404. Prázdná stránka se stavem 200 skončí v Search Console jako soft 404 a robot ji podle dokumentace bude dál navštěvovat.
08Strukturovaná data pro produkty
Google rozlišuje dva druhy produktových dat. Úryvek produktu je pro stránky, kde zboží koupit nejde, například recenze. Pro e-shop je určený záznam obchodníka: vyžaduje název, obrázek a nabídku Offer s cenou vyšší než nula a měnou. Kdo vyplní data pro záznam obchodníka, splní zpravidla i podmínky pro úryvek.
- Varianty: od 20. 2. 2024 Google podporuje typ ProductGroup s vlastnostmi hasVariant, variesBy a productGroupID.
- Drobečková navigace: od 23. 1. 2025 se ve výsledcích zobrazuje jen na počítači. BreadcrumbList má smysl dál, na mobilu ale drobečky neuvidíte.
- FAQ: rozšířený výsledek s otázkami Google přestal zobrazovat 7. 5. 2026. Otázky na stránce pomáhají lidem, vzhled výsledku už nezmění.
- Merchant Center: Google 18. 8. 2026 ukončil Content API for Shopping. Napojení feedu přes API je potřeba převést na Merchant API.
Seznam z produktových dat přebírá obrázek, cenu, hodnocení a skladovost. Chce data jen pro jeden produkt na stránce, cenu a měnu v Offer (ne přímo v Product) a bez měny cenu nezobrazí. Hodnocení e-shopu bere jen ze Zboží.cz od ověřených zákazníků. Pozor na ukázkový kód v jeho nápovědě: k 30. 9. 2026 obsahuje překlep aggergateRating. Kdo ho zkopíruje, tomu se hodnocení nenačte.
Hodnocení ve strukturovaných datech musí odpovídat tomu, co je na stránce. Od 6. 1. 2023 navíc platí § 5a odst. 5 zákona o ochraně spotřebitele: e-shop, který zobrazuje recenze, musí uvést, zda a jak ověřuje, že pocházejí od skutečných zákazníků. Falešné recenze a tvrzení o ověření bez přiměřených opatření k ověření řadí příloha zákona mezi vždy klamavé praktiky. Google v červenci 2026 doplnil do pravidel pro úryvky recenzí i výslovný zákaz falešných a nepřiznaně odměňovaných recenzí.
09Česká a slovenská verze e-shopu
Mnoho českých e-shopů prodává i na Slovensko. Různé jazykové verze nejsou duplicitou, pokud je přeložený hlavní obsah. Google to formuluje přesně: za duplicity považuje jazykové verze jen tehdy, když zůstane nepřeložené tělo stránky a přeloží se jen hlavička, patička a navigace. Slovenský e-shop s českými popisy produktů je tedy pro Google duplicitou české verze.
- Hreflang na obou stranách: každá verze musí uvádět sebe i ostatní, jinak je Google může ignorovat nebo vyložit špatně. Funguje i mezi doménami .cz a .sk.
- Správné kódy: jazyk je
cs, necz. Region se přidává za spojovník, tedycs-CZask-SK. - Kanonický odkaz ve stejném jazyce: slovenská stránka nemá kanonickým odkazem ukazovat na českou. Google to píše výslovně.
- Automatický překlad bez kontroly: pravidla Googlu proti hromadně generovanému obsahu zmiňují mezi příklady i strojový překlad, který čtenáři nic nepřidá.
10Jak svůj e-shop zkontrolovat za odpoledne
V Google Search Console otevřete přehled Indexování stránek a projděte důvody, proč stránky nejsou v indexu. Pro e-shop jsou nejdůležitější tyto stavy:
- Objeveno, momentálně neindexováno: Google o adrese ví, ale procházení odložil. Stovky až tisíce takových adres u produktů znamenají, že robot tráví čas jinde.
- Duplicitní stránka, Google vybral jinou kanonickou stránku než uživatel: váš kanonický odkaz nepřijal. Zkontrolujte, jestli stránky nejsou příliš rozdílné, nebo jestli interní odkazy nevedou na jinou verzi.
- Indexováno, ačkoli je přístup blokován souborem robots.txt: adresy, které jste zakázali pozdě. Pokud je chcete z indexu dostat, dočasně je povolte a dejte jim noindex.
- Soft 404: prázdné kategorie, neexistující stránkování, filtry bez výsledků.
Na Seznamu použijte Seznam Webmaster. Je pořád v betaverzi, ukazuje ale počet stažených, indexovaných a chybových stránek. Změněné stránky pošlete k reindexaci ručně, přes jeho API (až 500 adres denně) nebo protokolem IndexNow, který počet adres neomezuje. Ten ale Seznam bere jen jako informaci, zařazení do indexu nezaručuje.
Nakonec si z pohledu robota projděte jednu kategorii:
- Otevřete ji s řazením, jedním filtrem, dvěma filtry a s
?utm_source=test. Má každá verze správnou značku robots a kanonický odkaz? - Zadejte neexistující stranu výpisu, třeba 99. Vrátí web 404?
- Zkuste adresu s http://, bez lomítka na konci a s velkými písmeny. Skončíte jedním přesměrováním na správnou verzi?
- Vedou odkazy „Do košíku“ a „Do oblíbených“ na adresy s parametrem? Pokud ano, patří do robots.txt.
- Obsahuje sitemapa jen adresy, které vracejí 200 a mají kanonický odkaz samy na sebe?
Pokud vám kontrola ukáže, že současná platforma filtry a adresy ovládat nedovolí, přečtěte si srovnání krabicového e-shopu a e-shopu na míru. U e-shopů na míru řešíme strukturu kategorií, filtrů a adres už při návrhu.
11Časté otázky
Penalizuje Google e-shop za duplicitní obsah?
Za běžné duplicity uvnitř e-shopu ne. Google duplicitní adresy seskupí a zobrazí jednu z nich. Vadí to hlavně tím, že se signály rozdělí a ve výsledcích může být jiná verze, než chcete. Postih hrozí za kopírování cizího obsahu s cílem manipulovat výsledky.
Mám filtry v e-shopu indexovat?
Jen ty kombinace, které lidé hledají a které mají dost produktů, vlastní nadpis a úvod. Ostatní filtry nechte zákazníkům a vyhledávačům je zavřete, ideálně zákazem v robots.txt nebo zápisem za znak # v adrese.
Stačí na filtry kanonický odkaz na kategorii?
U menšího e-shopu často ano, jde ale jen o nápovědu. Robot filtrované stránky dál prochází a vyhledávač kanonický odkaz nemusí přijmout. Google v dokumentaci k fasetové navigaci doporučuje na prvním místě filtry v robots.txt zakázat, u velkých katalogů to platí dvojnásob.
Můžu použít noindex a zároveň stránku zakázat v robots.txt?
Nedává to smysl. Robot zakázanou stránku nestáhne, takže noindex neuvidí. Zvolte jedno: noindex, když chcete stránku dostat z indexu, robots.txt, když ji nechcete nechat procházet.
Co udělat s vyprodaným produktem?
Dočasně vyprodaný nechte na webu a označte jako nedostupný, i ve strukturovaných datech. Trvale zrušený vraťte jako 404 nebo 410, případně přesměrujte na skutečnou náhradu. Na Seznamu vyřadí kód 410 stránku rychleji.
Musím řešit Seznam zvlášť?
Většina pravidel platí pro oba vyhledávače. Seznam ale ignoruje hlavičku X-Robots-Tag, takže noindex musí být přímo v HTML. Sitemapu chce uvedenou v robots.txt a hodnocení e-shopu ve výsledcích přebírá jen ze Zboží.cz.
12Zdroje
- Google: fasetová navigace (anglicky)
- Google: Crawling December, fasetová navigace, 2024 (anglicky)
- Search Off the Record: přepis epizody o problémech s procházením 2025 (anglicky, PDF)
- Google: kanonizace (anglicky)
- Google: sloučení duplicitních adres (anglicky)
- Google: řešení problémů s kanonizací (anglicky)
- Google: pravidla proti spamu (anglicky)
- Google: noindex (anglicky)
- Google: úvod do robots.txt (anglicky)
- Google: duplicitní obsah a penalizace, 2008 (anglicky)
- Google: stránkování v e-shopech (anglicky)
- Google: struktura adres e-shopu (anglicky)
- Google: struktura e-shopu a interní odkazy (anglicky)
- Google: zrušení nástroje Parametry URL (anglicky)
- Google: kapacita procházení (anglicky)
- Google: stavové kódy HTTP (anglicky)
- Google: pozastavení prodeje a vyprodané zboží (anglicky)
- Google: strukturovaná data produktu (anglicky)
- Google: záznam obchodníka (anglicky)
- Google: varianty produktů, 2024 (anglicky)
- Google: drobečková navigace jen na počítači, 2025 (anglicky)
- Google: přehled změn dokumentace (anglicky)
- Google: jazykové verze a hreflang (anglicky)
- Google: přehled Indexování stránek v Search Console
- Google: přechod z Content API na Merchant API (anglicky)
- Seznam: kanonické URL
- Seznam: meta tag robots
- Seznam: přesměrování URL
- Seznam: přesměrování webu
- Seznam: odstraňování stránek
- Seznam: optimalizační minimum
- Seznam: zakázané a nevhodné techniky
- Seznam: průběh vyhledávání
- Seznam: produktové snippety
- Seznam Webmaster
- Seznam: protokol IndexNow
- StatCounter: vyhledávače v Česku (anglicky)
- Eurostat: nákupy jednotlivců přes internet (anglicky)
- APEK: obraty e-shopů v roce 2025
- Baymard Institute: výpisy zboží a filtry (anglicky)
- Shoptet: parametrické kategorie
- Shoptet: doplněk Pokročilé SEO
- Heureka: specifikace XML feedu
- Zboží.cz: specifikace XML feedu
- eVisions: případová studie filtrace
- Zákon č. 634/1992 Sb., o ochraně spotřebitele
Údaje platí k 30. 9. 2026. Měření dema Shoptetu proběhlo 30. 9. 2026 ve výchozím nastavení, konkrétní e-shop může být nastavený jinak.