Nejlepší AI modely září 2026: velké srovnání GPT-6 Astra, Claude Fable 5.1, Gemini, Grok, Muse, DeepSeek a MiMo
Za tři zářijové týdny vyšlo sedm špičkových AI modelů a žádný z nich nevyhrává ve všem. GPT-6 Astra a Claude Fable 5.1 mají v nezávislém indexu shodně nejvíc bodů, Astra nejlépe ovládá počítač, Muse Spark 1.3 má podle Mety nejvyšší skóre v dlouhém programování, MiMo V2.6 Pro je nejlepší otevřený model a DeepSeek-V4.1-Flash je mimo špičku nejlevnější. Porovnali jsme je v cenách, architektuře a deseti benchmarcích.
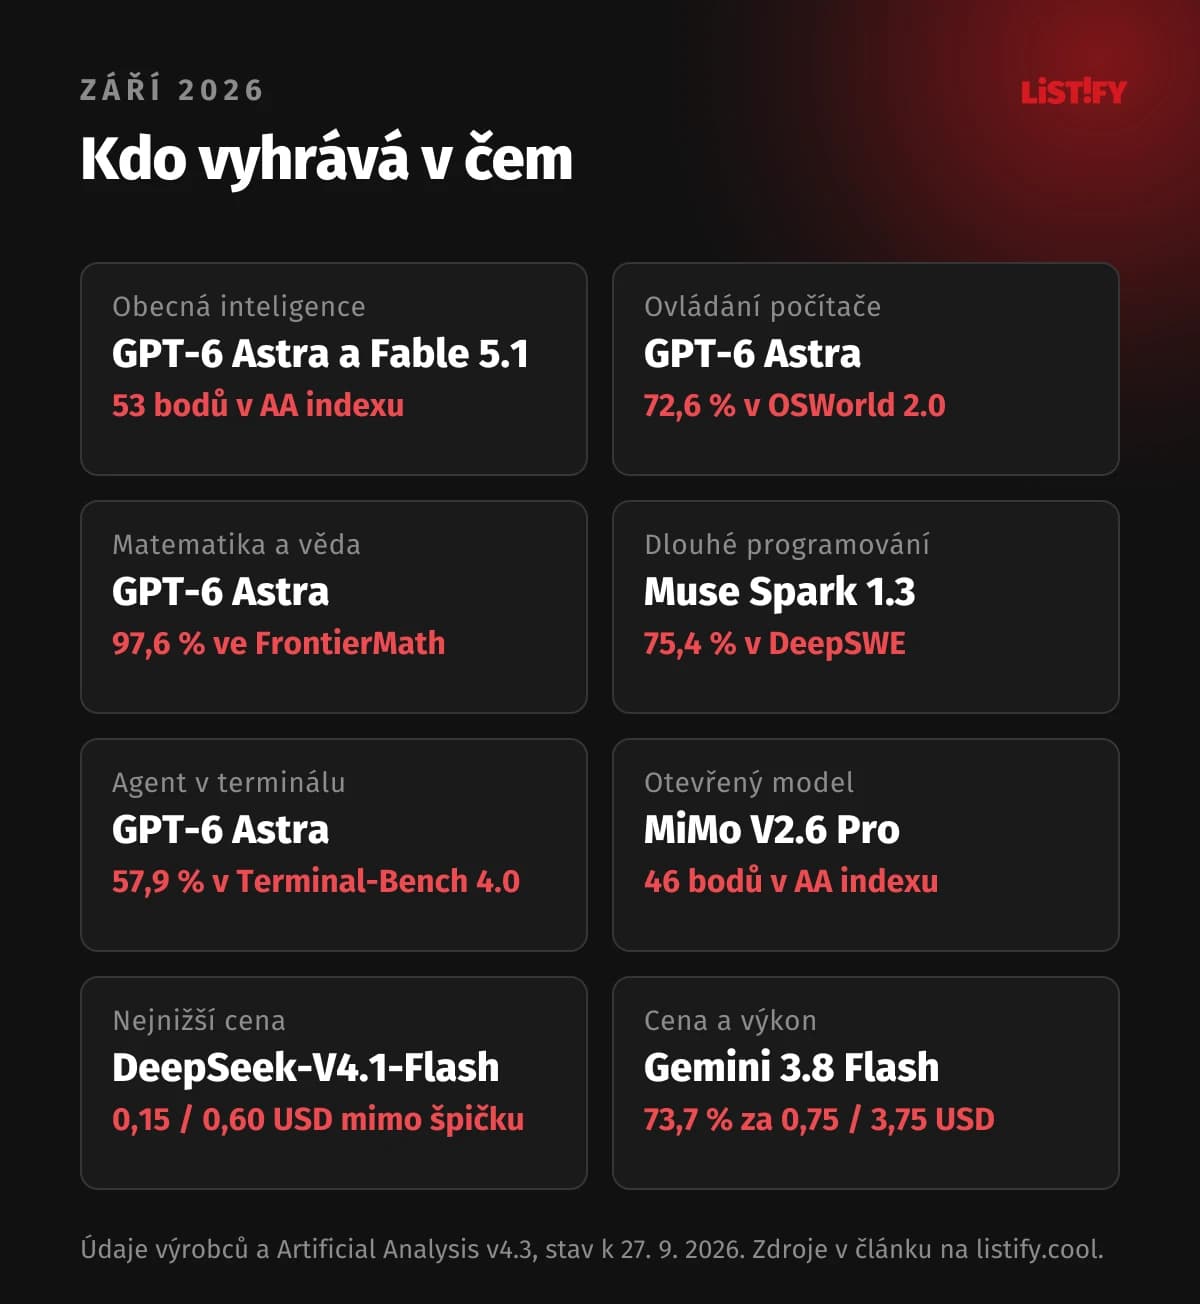
01Kdo vyhrává v čem
| Kategorie | Vítěz | Klíčové číslo |
|---|---|---|
| Obecná inteligence | GPT-6 Astra a Claude Fable 5.1 | shodně 53 bodů v AA Intelligence Index v4.3 |
| Ovládání počítače | GPT-6 Astra | 72,6 % v OSWorld 2.0 |
| Matematika a věda | GPT-6 Astra | 97,6 % ve FrontierMath Tier 4 |
| Dlouhé programovací úlohy | Muse Spark 1.3 | 75,4 % v DeepSWE v1.1 (údaj Mety) |
| Agent v terminálu | GPT-6 Astra | 57,9 % v Terminal-Bench 4.0 |
| Otevřený model | MiMo V2.6 Pro | 46 bodů v AA Intelligence Index v4.3 |
| Nejnižší cena | DeepSeek-V4.1-Flash mimo špičku | 0,15 / 0,60 USD |
| Cena a výkon u uzavřených modelů | Gemini 3.8 Flash | 73,7 % v DeepSWE za 0,75 / 3,75 USD |
Každému modelu jsme věnovali samostatný průvodce, odkazy najdete v přehledové tabulce níže. Tady je porovnáváme vedle sebe.
02Přehled: 7 AI modelů v jedné tabulce
Čtyři americké firmy, Meta a dva hráči z Číny vydali během tří týdnů modely, jejichž ceny se liší až osmdesátkrát. Otevřené váhy pod licencí MIT mají jen DeepSeek a MiMo.
| Model | Výrobce | Vydán | Váhy | Kontext | Vstup / výstup (USD za 1 mil.) |
|---|---|---|---|---|---|
| GPT-6 Astra | OpenAI | 3. 9. 2026 | uzavřené | 1,05 mil. | 10 / 50 |
| Claude Fable 5.1 | Anthropic | 1. 9. 2026 | uzavřené | 1 mil. | 10 / 50 |
| Gemini 3.8 Flash | 2. 9. 2026 | uzavřené | 1 mil. | 0,75 / 3,75 (do konce 2026) | |
| Grok 4.7 | xAI (SpaceXAI) | 21. 9. 2026 | uzavřené | 500 tis. | 2 / 6 |
| Muse Spark 1.3 | Meta | 2. 9. 2026 | uzavřené | 1,05 mil. | 1,25 / 4,25 |
| DeepSeek-V4.1-Flash | DeepSeek | 10. 9. 2026 | otevřené (MIT) | 1 mil. | 0,30 / 1,20 (ve špičce) |
| MiMo V2.6 Pro | Xiaomi | 22. 9. 2026 | otevřené (MIT) | 1 mil. | 0,435 / 0,87 |
Mimo srovnání: 22. září vyšel ještě Claude Opus 5.5. Stojí 4 / 20 USD a v indexu Artificial Analysis v4.3 vede celý žebříček s 58 body, podle Anthropicu pracuje na úrovni Fable 5.1 za nižší cenu. Týž den OpenAI přidala modely GPT-6 Sol a GPT-6 Luna. Srovnání se drží sedmi modelů ze začátku a poloviny září, Opus 5.5 ukazujeme pro kontext v grafu inteligence. (Anthropic)
03Časová osa: září 2026 den po dni
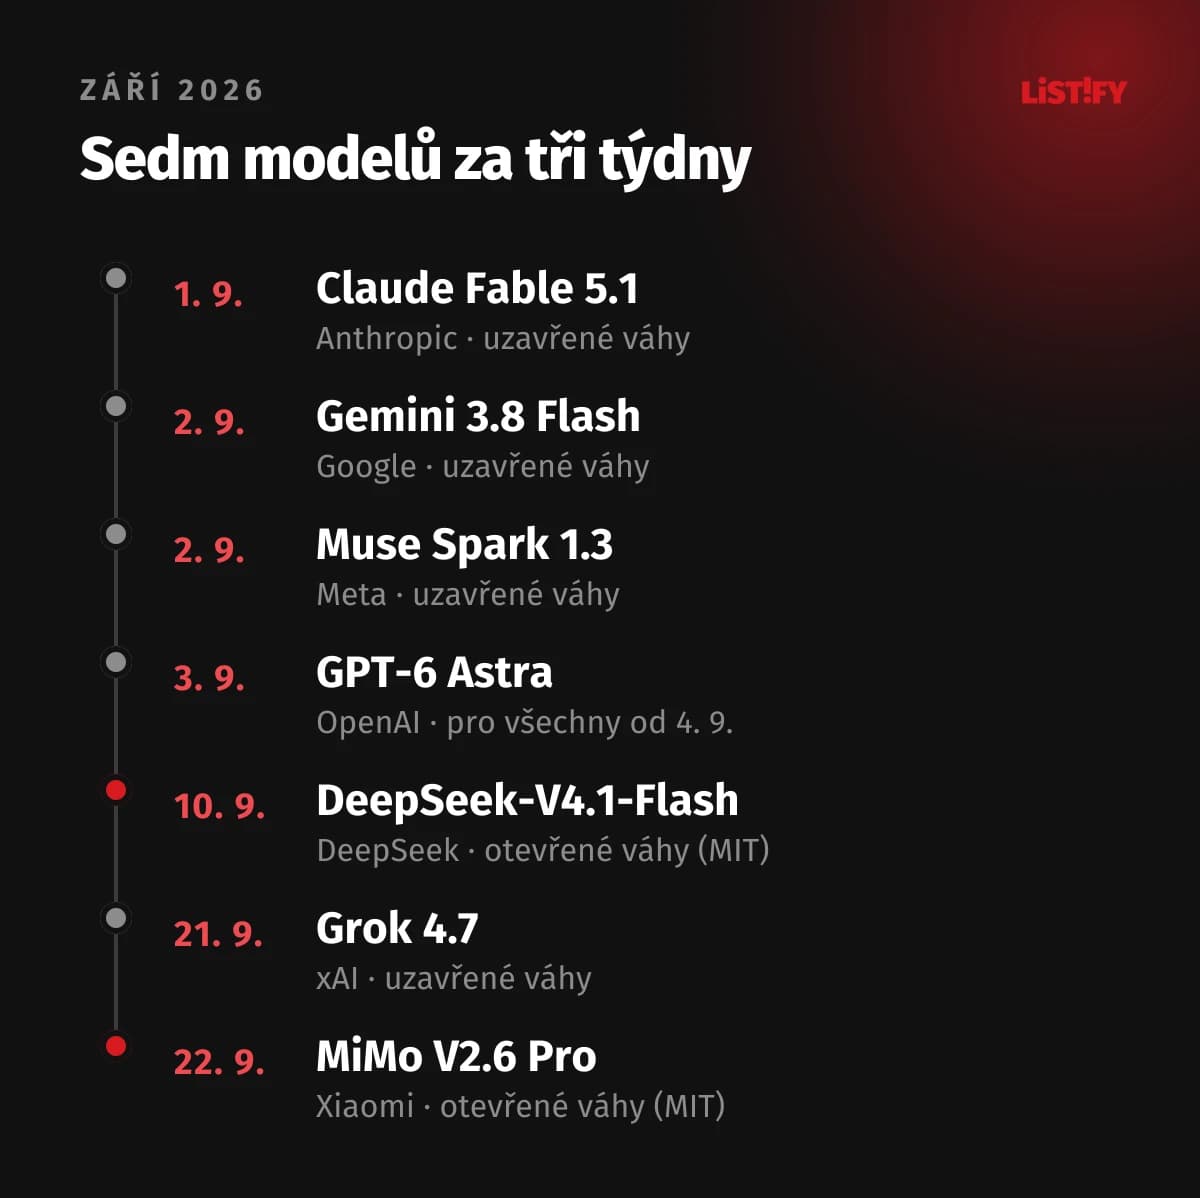
Za první tři zářijové dny vyšly čtyři modely. Anthropic začal 1. září, Google a Meta přidaly svoje o den později a OpenAI třetího. GPT-6 Astra byla nejdřív jen v omezené ukázce, všem uživatelům se otevřela 4. září. Otevřené modely z Číny přišly později: DeepSeek 10. září, Xiaomi až 22. září, den po Groku.
04Architektura a kontextové okno
OpenAI, Anthropic, Google ani Meta počet parametrů nezveřejňují. Čínské otevřené modely naopak ukazují všechno: oba stojí na architektuře mixture-of-experts (MoE), kde na každý token pracuje jen malá část sítě.
| Model | Parametry celkem | Aktivní na token | Architektura | Max. výstup | Vstupy |
|---|---|---|---|---|---|
| GPT-6 Astra | nezveřejněno | nezveřejněno | nezveřejněno | 128 tis. | neuvedeno |
| Claude Fable 5.1 | nezveřejněno | nezveřejněno | adaptivní uvažování | 128 tis. | neuvedeno |
| Gemini 3.8 Flash | nezveřejněno | nezveřejněno | nezveřejněno | 65 536 | text, obrázky, zvuk, video, dokumenty |
| Grok 4.7 | asi 2,1 bil. (podle Elona Muska) | nezveřejněno | nový větší základní model | bez pevného limitu | text, obrázky |
| Muse Spark 1.3 | nezveřejněno | nezveřejněno | nativně multimodální | neuvedeno | text, obrázky, video, PDF, zvuk omezeně |
| DeepSeek-V4.1-Flash | 552 mld. + 196 mld. Engram | 8 mld. (vstup), 16 mld. (generování) | MoE, kauzální enkodér a dekodér | 384 tis. | text, obrázky |
| MiMo V2.6 Pro | 1,02 bil. | 42 mld. | MoE se zmrazeným routerem | 128 tis. | text, obrázky, video, zvuk |
- GPT-6 Astra1 050
- Muse Spark 1.31 049
- Claude Fable 5.11 000
- Gemini 3.8 Flash1 000
- DeepSeek-V4.1-Flash1 000
- MiMo V2.6 Pro1 000
- Grok 4.7500
Zdroj: dokumentace výrobců. Muse Spark 1.3 má přesně 1 048 576 tokenů. Grok 4.7 má jako jediný poloviční okno a od 200 tisíc tokenů účtuje dvojnásobnou cenu.
Do milionu tokenů se vejde středně velký repozitář nebo několik set stran dokumentů. Rozdíl je v tom, kolik dlouhý kontext stojí. Muse Spark 1.3 si za plné okno nic nepřipočítává, Grok 4.7 od 200 tisíc tokenů účtuje dvojnásobek. DeepSeek díky kompresi potřebuje na token jen 890 bajtů paměti KV cache, a proto je levný i u agentů s obrovským vstupem.
05Ceny API: který AI model je nejlevnější
Nejlevnější jsou otevřené modely z Číny. MiMo V2.6 Pro stojí za milion vstupních a milion výstupních tokenů dohromady 1,31 USD, GPT-6 Astra a Claude Fable 5.1 60 USD, tedy zhruba 46krát víc. DeepSeek-V4.1-Flash stojí ve špičce 1,50 USD a mimo špičku polovinu.
- GPT-6 Astra60,00 USD
- Claude Fable 5.160,00 USD
- Grok 4.78,00 USD
- Muse Spark 1.35,50 USD
- Gemini 3.8 Flash4,50 USD
- DeepSeek-V4.1-Flash (špička)1,50 USD
- MiMo V2.6 Pro1,31 USD
- DeepSeek-V4.1-Flash (mimo špičku)0,75 USD
Podle ceníků výrobců. Gemini za úvodní cenu platnou do konce roku 2026, Grok pro prompty do 200 tisíc tokenů, Muse v tarifu Standard. Špička DeepSeeku jsou pracovní dny 1:00 až 4:00 a 6:00 až 10:00 UTC.
- Grok 4.7Vstup: 2,00 USDVýstup: 6,00 USD
- Muse Spark 1.3Vstup: 1,25 USDVýstup: 4,25 USD
- Gemini 3.8 FlashVstup: 0,75 USDVýstup: 3,75 USD
- DeepSeek-V4.1-Flash (špička)Vstup: 0,30 USDVýstup: 1,20 USD
- MiMo V2.6 ProVstup: 0,43 USDVýstup: 0,87 USD
GPT-6 Astra a Claude Fable 5.1 (10 / 50 USD) by se do měřítka nevešly. MiMo V2.6 Pro má vstup přesně 0,435 USD.
Podrobný ceník
| Model | Vstup | Vstup z cache | Výstup | Poznámka |
|---|---|---|---|---|
| GPT-6 Astra | 10 USD | 1 USD | 50 USD | režim Fast za dvojnásobek |
| Claude Fable 5.1 | 10 USD | 0,25 USD | 50 USD | nejlevnější cache mezi vlajkovými modely |
| Grok 4.7 | 2 USD | 0,50 USD | 6 USD | od 200 tis. tokenů dvojnásobek; OpenRouter 1,60 / 4,80 USD |
| Muse Spark 1.3 | 1,25 USD | 0,15 USD | 4,25 USD | tarif Contributor 0,10 / 0,20 USD, Meta ale trénuje na vašich datech |
| Gemini 3.8 Flash | 0,75 USD | neuvedeno | 3,75 USD | od 1. 1. 2027 za 1,50 / 7,50 USD |
| DeepSeek-V4.1-Flash | 0,30 USD | 0,006 USD | 1,20 USD | mimo špičku za polovinu |
| MiMo V2.6 Pro | 0,435 USD | 0,0036 USD | 0,87 USD | verze Flash za 0,14 / 0,28 USD |
Cena za token není cena za úlohu. GPT-6 Astra i Muse Spark 1.3 potřebují na stejnou práci méně tokenů než jejich předchůdci a Claude Fable 5.1 díky levné cache vychází u agentů o 25 až 45 % levněji než Fable 5. Skutečný rozdíl v účtu proto bývá menší, než ukazuje graf. Při plánování rozpočtu na rok 2027 počítejte s dražším Gemini 3.8 Flash.
06Celková inteligence: který AI model je nejchytřejší
V nezávislém Artificial Analysis Intelligence Index v4.3 se o první místo mezi sedmi modely dělí GPT-6 Astra a Claude Fable 5.1 s 53 body. Nejlepší otevřený model je MiMo V2.6 Pro se 46 body. Celý žebříček ale vede Claude Opus 5.5, který vyšel 22. září.
- Claude Opus 5.5 (mimo srovnání)58
- GPT-6 Astra53
- Claude Fable 5.153
- Muse Spark 1.3 (max)48
- Grok 4.746
- MiMo V2.6 Pro46
- Gemini 3.8 Flash41
- DeepSeek-V4.1-Flash39
Zdroj: Artificial Analysis, stav k 27. 9. 2026. Grok 4.7 má po zaokrouhlení těsně víc než MiMo (46,45 proti 46,32). Muse Spark 1.3 na úrovni xhigh má 45 bodů.
Pozor na starší verzi indexu. Do začátku září platila verze v4.1 s jinou stupnicí a řada článků ji pořád cituje: Claude Fable 5.1 tam měl 65,7 bodu a GPT-6 Astra 61,2. Verze v4.3 hodnotí přísněji a body mezi verzemi se nedají přepočítat ani míchat v jednom srovnání. V tomto článku používáme jen v4.3, stejně jako v našich průvodcích.
Rozdíl 53 proti 46 bodům je zřetelný, ale v běžné práci ho nepoznáte na každé úloze. Víc napoví výsledky v oblasti, kterou potřebujete, proto je rozebíráme v dalších kapitolách.
07Programování: nejlepší AI model na kód
V dlouhých programovacích úlohách (DeepSWE) jsou modely skoro vyrovnané a levné modely dohnaly vlajkové. Rozdíl se ukáže až v těžším testu agenta v terminálu. V Terminal-Bench 4.0 mají GPT-6 Astra a Claude Fable 5.1 o polovinu až trojnásobně vyšší úspěšnost než levnější modely.
- Muse Spark 1.375,4 %
- DeepSeek-V4.1-Flash74,2 %
- GPT-6 Astra74,1 %
- Gemini 3.8 Flash73,7 %
- MiMo V2.6 Pro71,9 %
- Grok 4.771,0 %
- Claude Fable 5.167,4 %
Údaje výrobců, každý měřil ve vlastním prostředí, srovnání je orientační. Claude Fable 5.1 podle tabulky OpenAI; xAI uvádí 70,0 %, Anthropic číslo nezveřejnil.
- GPT-6 Astra57,9 %
- Claude Fable 5.155,8 %
- Grok 4.737,6 %
- MiMo V2.6 Pro34,9 %
- DeepSeek-V4.1-Flash31,2 %
- Gemini 3.8 Flash19,1 %
Údaje výrobců: OpenAI, Anthropic, xAI, Xiaomi, Hugging Face, Agentpedia. Muse Spark 1.3 výsledek nezveřejnil.
- DeepSeek-V4.1-Flash90,6 %
- MiMo V2.6 Pro89,9 %
- Gemini 3.8 Flash89,4 %
- Muse Spark 1.388,8 %
Údaje výrobců. GPT-6 Astra, Claude Fable 5.1 a Grok 4.7 výsledek v této verzi nezveřejnily.
- DeepSWE už skoro nerozlišuje. Šest ze sedmi modelů se vešlo mezi 71 a 75,4 %, Claude Fable 5.1 má podle tabulky OpenAI 67,4 %. Nejvyšší skóre Muse Spark 1.3 je navíc měření Mety, které zatím není ve veřejném žebříčku DeepSWE.
- Terminal-Bench 4.0 odděluje třídy. GPT-6 Astra (57,9 %) a Claude Fable 5.1 (55,8 %) jsou tam, kam levnější modely zatím nedosáhnou. Grok 4.7 má 37,6 %, Gemini 3.8 Flash 19,1 %.
- Terminal-Bench 2.1 je nasycený. Levné modely se v něm tísní kolem 90 % a test mezi nimi nic neodliší.
- Nezávislá měření: CursorBench 3.2 dává Claude Fable 5.1 73,4 % a Gemini 3.8 Flash 69,2 % (BenchLM), AA Coding Agent Index dává Fable 5.1 70 bodů a GPT-6 Astra 67 (MindStudio).
Na běžné opravy chyb a menší úpravy kódu stačí levný model. Na samostatnou práci v terminálu, která trvá hodiny, se vlajkové modely pořád vyplatí.
08Ovládání počítače a AI agenti
V ovládání počítače vede podle srovnávací tabulky OpenAI GPT-6 Astra se 72,6 % v OSWorld 2.0. Anthropic hlásí pro Claude Fable 5.1 ještě vyšší číslo, jenže na jiné sadě úloh. V testu firemních procesů AutomationBench levné modely podle vlastních měření vycházejí lépe než GPT-6 Astra i Claude Fable 5.1.
- Claude Fable 5.1 (partial, sada Anthropicu)77,9 %
- GPT-6 Astra72,6 %
- Muse Spark 1.3 max (partial)66,9 %
- Gemini 3.8 Flash59,0 %
Každý výrobce měřil na jiné sadě úloh nebo s jiným hodnocením, čísla tedy nejsou přímo srovnatelná. Anthropic měřil na srpnové sadě 2026 (v přísné variantě strict má Fable 5.1 41,7 %). Grok, DeepSeek a MiMo výsledek nezveřejnily.
- DeepSeek-V4.1-Flash54,8 %
- MiMo V2.6 Pro53,1 %
- Muse Spark 1.349,6 %
- GPT-6 Astra41,4 %
- Claude Fable 5.131,4 %
Údaje výrobců: Hugging Face, Xiaomi, Meta, OpenAI, Anthropic. Verze testu se u výrobců může lišit.
- OSWorld není jeden test. Anthropic měřil na srpnové sadě úloh a uvádí variantu partial. OpenAI měřilo ve vlastní konfiguraci a Meta verzi max. V tabulce OpenAI má GPT-6 Astra 72,6 % a Claude Opus 5 70,2 %, proto ji v ovládání počítače vedeme jako vítěze.
- Astra je nejrychlejší. Úlohu v OSWorld 2.0 zvládne asi za 40 minut, GPT-5.6 Sol za 75.
- Výsledky levných modelů v AutomationBench je potřeba ověřit. DeepSeek (54,8 %), MiMo (53,1 %) i Muse (49,6 %) uvádějí svá čísla sami. U Claude Fable 5.1 (31,4 %) se čísla OpenAI a Anthropicu shodují, GPT-6 Astra (41,4 %) je údaj OpenAI. Xiaomi v novější verzi testu uvádí pro Astru 52,0 %.
- Hotové produkty s ovládáním počítače nabízí hlavně OpenAI (ChatGPT Work, Codex) a Anthropic (Claude Code, Claude Cowork). U otevřených modelů si agentní prostředí obvykle postavíte sami.
09Věda, matematika a uvažování
Ve vědeckých otázkách jsou modely skoro vyrovnané. V nejtěžší matematice jasně vede GPT-6 Astra, v multioborovém testu Humanity’s Last Exam Claude Fable 5.1.
- GPT-6 Astra96,0 %
- Gemini 3.8 Flash95,3 %
- Claude Fable 5.193,7 %
- DeepSeek-V4.1-Flash90,9 %
Údaje výrobců, Gemini 3.8 Flash podle měření Artificial Analysis (Google hodnotu neuvádí).
- Claude Fable 5.165,0 %
- DeepSeek-V4.1-Flash63,9 %
- GPT-6 Astra57,2 %
Údaje výrobců. Ostatní modely tuto variantu testu nezveřejnily.
Nejtěžší testy zveřejnily jen OpenAI a Anthropic
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Co měří |
|---|---|---|---|
| FrontierMath Tier 4 (v2) | 97,6 % | 87,8 % | výzkumná matematika |
| Terminal-Bench Science 0.1 | 64,6 % | 52,6 % | vědecký výzkum v terminálu |
| ARC-AGI-2 | 95,0 % | 90,0 % | abstraktní uvažování |
| ARC-AGI-3 | 99,9 % v upraveném prostředí, 62,7 % ve standardním testu | neuvedeno | abstraktní uvažování |
OpenAI zveřejnila s Astrou nové výsledky o mezerách mezi prvočísly a sama žádá matematiky o jejich prověření; z 68 nevyřešených Erdősových problémů Astra oficiálně vyřešila dva. Claude Fable 5.1 víc než zdvojnásobil skóre Fable 5 v Terminal-Bench Science. Xiaomi ukazuje formalizaci věty v jazyce Lean 4 s víc než 6 000 řádky ověřeného kódu. Spolehlivý samostatný výzkum ale zatím nezvládá žádný z modelů. (OpenAI, Anthropic, Xiaomi)
10Kybernetická bezpečnost a ochranná opatření
Nejsilnější výsledky v hledání zranitelností hlásí otevřené modely, které ale žádné centrální pojistky nemají. Vlajkové modely jsou naopak hlídané nejpřísněji. GPT-6 Astra jako první model OpenAI dosáhla „kritické“ úrovně kybernetických schopností, a veřejná verze proto odmítá psát exploity.
- MiMo V2.6 Pro94,0 %
- DeepSeek-V4.1-Flash88,1 %
- Gemini 3.8 Flash Cyber86,2 %
Údaje výrobců: Xiaomi, Hugging Face, Agentpedia. U Gemini jde o specializovanou verzi Cyber. OpenAI, Anthropic, xAI a Meta výsledek nezveřejnily.
- GPT-5.6 Sol (starší)22,0 %
- Claude Opus 5 (starší)11,5 %
- Claude Fable 5.19,5 %
- GPT-6 Astra2,4 %
Interní test OpenAI bez produkčních pojistek, tedy měření jednoho z konkurentů.
Jak k bezpečnosti přistupují výrobci
| Model | Přístup | Silnější verze pro ověřené |
|---|---|---|
| GPT-6 Astra | odmítá exploity, klasifikátory zastaví neautorizovanou činnost | program Daybreak (připravuje se) |
| Claude Fable 5.1 | citlivé kybernetické dotazy předá slabšímu modelu Opus, hledání zranitelností je povolené | Claude Mythos 5.1, zatím jen v programu pro vědy o živé přírodě; kybernetický program nabízí Opus a Sonnet |
| Gemini 3.8 Flash | standardní model v kybernetických testech neměřený | Gemini 3.8 Flash Cyber v programu Fairwind |
| Grok 4.7 | nová sada pojistek, v interním testu prošlo 3,3 % rizikových požadavků | red-team schopnosti na pozvání |
| Muse Spark 1.3 | podle Mety odolnější vůči prompt injection a opatrný u nevratných akcí | neuvedeno |
| DeepSeek-V4.1-Flash | otevřené váhy, při vlastním provozu žádné centrální pojistky | není potřeba |
| MiMo V2.6 Pro | otevřené váhy, nezávislých testů je zatím málo | není potřeba |
U otevřených modelů za pravidla použití odpovídáte sami. U uzavřených počítejte s tím, že legitimní bezpečnostní práce, třeba penetrační testy nebo vývoj exploitů, narazí na odmítnutí, dokud nezískáte přístup ke speciální verzi.
11Otevřené a uzavřené modely: kam putují vaše data
Pokud data nesmí opustit vaši infrastrukturu, zbývají DeepSeek-V4.1-Flash a MiMo V2.6 Pro. Oba mají otevřené váhy pod licencí MIT a dají se provozovat na vlastních serverech. U všech ostatních jdou prompty vždy k výrobci nebo jeho cloudovému partnerovi.
| Model | Váhy | Kde běží | Ochrana dat |
|---|---|---|---|
| GPT-6 Astra | uzavřené | OpenAI API, Microsoft Azure, Amazon Bedrock | Zero Data Retention pro vybrané zákazníky |
| Claude Fable 5.1 | uzavřené | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry | Zero Data Retention pro oprávněné zákazníky |
| Gemini 3.8 Flash | uzavřené | Gemini API, Google AI Studio, aplikace Gemini | podle podmínek Google |
| Grok 4.7 | uzavřené | xAI API, OpenRouter, Vercel, Cloudflare | regionální endpoint v USA za příplatek 10 % |
| Muse Spark 1.3 | uzavřené | Meta Model API, OpenRouter, LLM Gateway | v tarifu Contributor Meta trénuje na vašich datech, nastavení v Muse Code si zkontrolujte |
| DeepSeek-V4.1-Flash | otevřené (MIT) | vlastní servery, třetí strany (např. NVIDIA), přímé API | přímé API provozuje firma se sídlem v Číně |
| MiMo V2.6 Pro | otevřené (MIT) | vlastní servery, OpenRouter, API Xiaomi | API Xiaomi běží na čínských serverech |
Vlastní provoz není zadarmo. DeepSeek-V4.1-Flash má 552 miliard parametrů a i kvantizovaná verze potřebuje stovky gigabajtů paměti. Komunitní sestavení běží například na dvou kartách RTX PRO 6000 s 96 GB. MiMo V2.6 Pro s 1,02 bilionu parametrů je ještě náročnější, praktičtější je menší MiMo V2.6 Flash s 309 miliardami. (MindStudio)
Pro firmy v EU: model provozovaný na vlastní infrastruktuře v Evropě řeší otázku, kam data odcházejí. U API všech výrobců si konkrétní podmínky zpracování ověřte s právníkem.
12Výkon za dolar: nejvýhodnější AI model
V programování dostanete skoro stejný výsledek za zlomek ceny. DeepSeek-V4.1-Flash má v DeepSWE stejné skóre jako GPT-6 Astra a i ve špičce stojí čtyřicetinu.
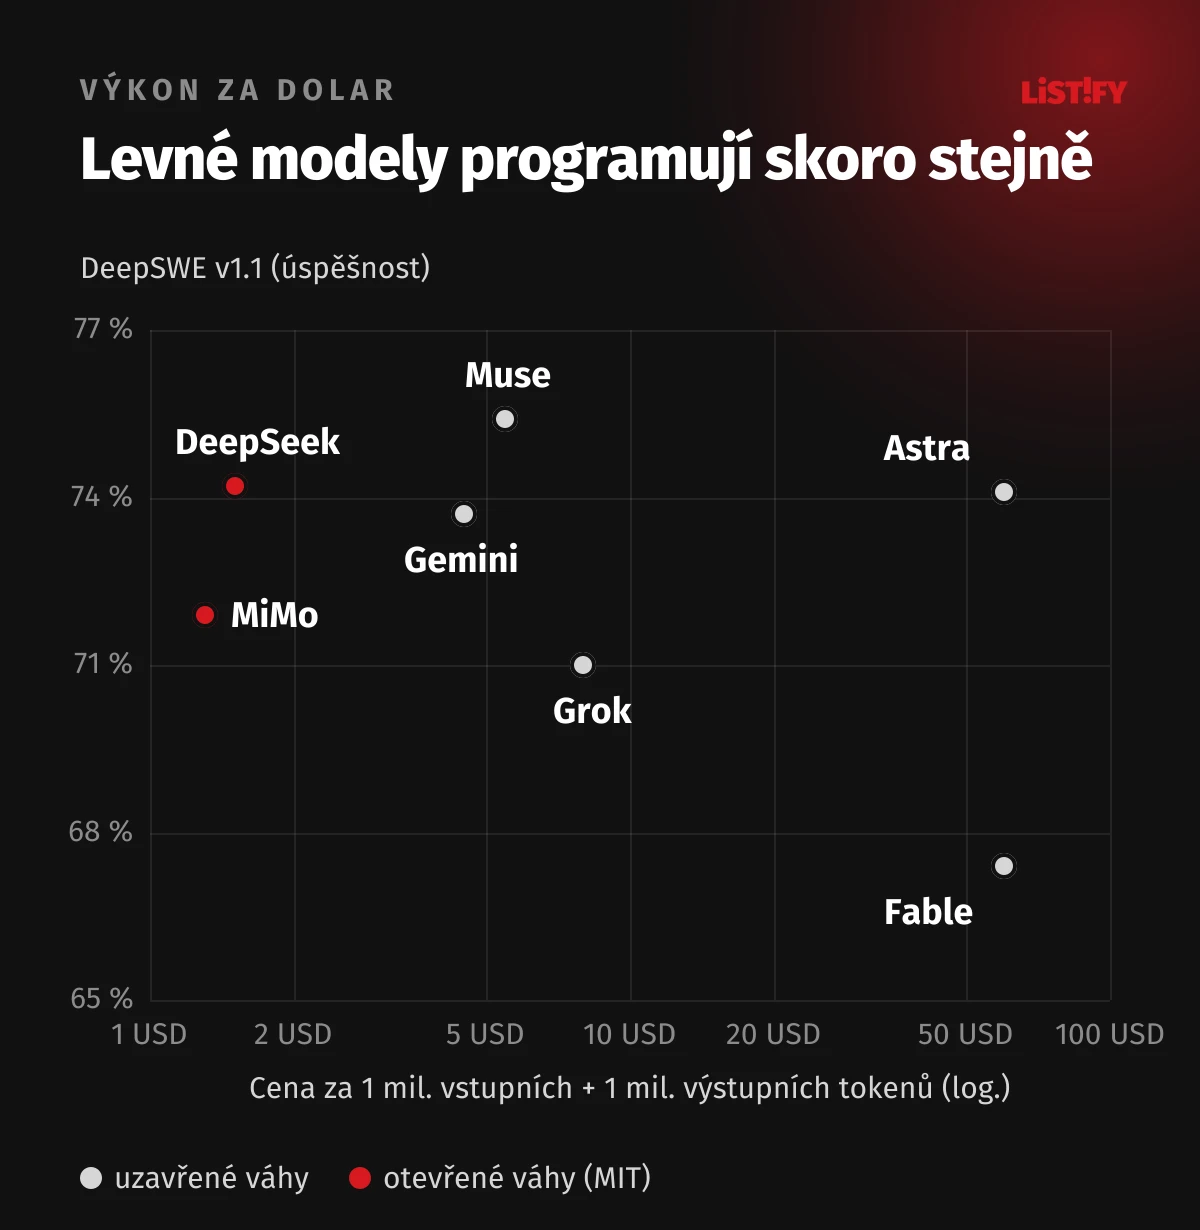
Graf má dvě omezení. DeepSWE měří jen dlouhé softwarové úlohy; v těžším Terminal-Bench 4.0 mají GPT-6 Astra a Claude Fable 5.1 velký náskok (57,9 a 55,8 % proti 31,2 % u DeepSeeku). A levný model, který úlohu vyřeší až na třetí pokus, může nakonec vyjít dráž než drahý, který ji zvládne napoprvé. Měřte proto cenu za přijatelnou odpověď na vlastních úlohách.
13Který AI model zvolit
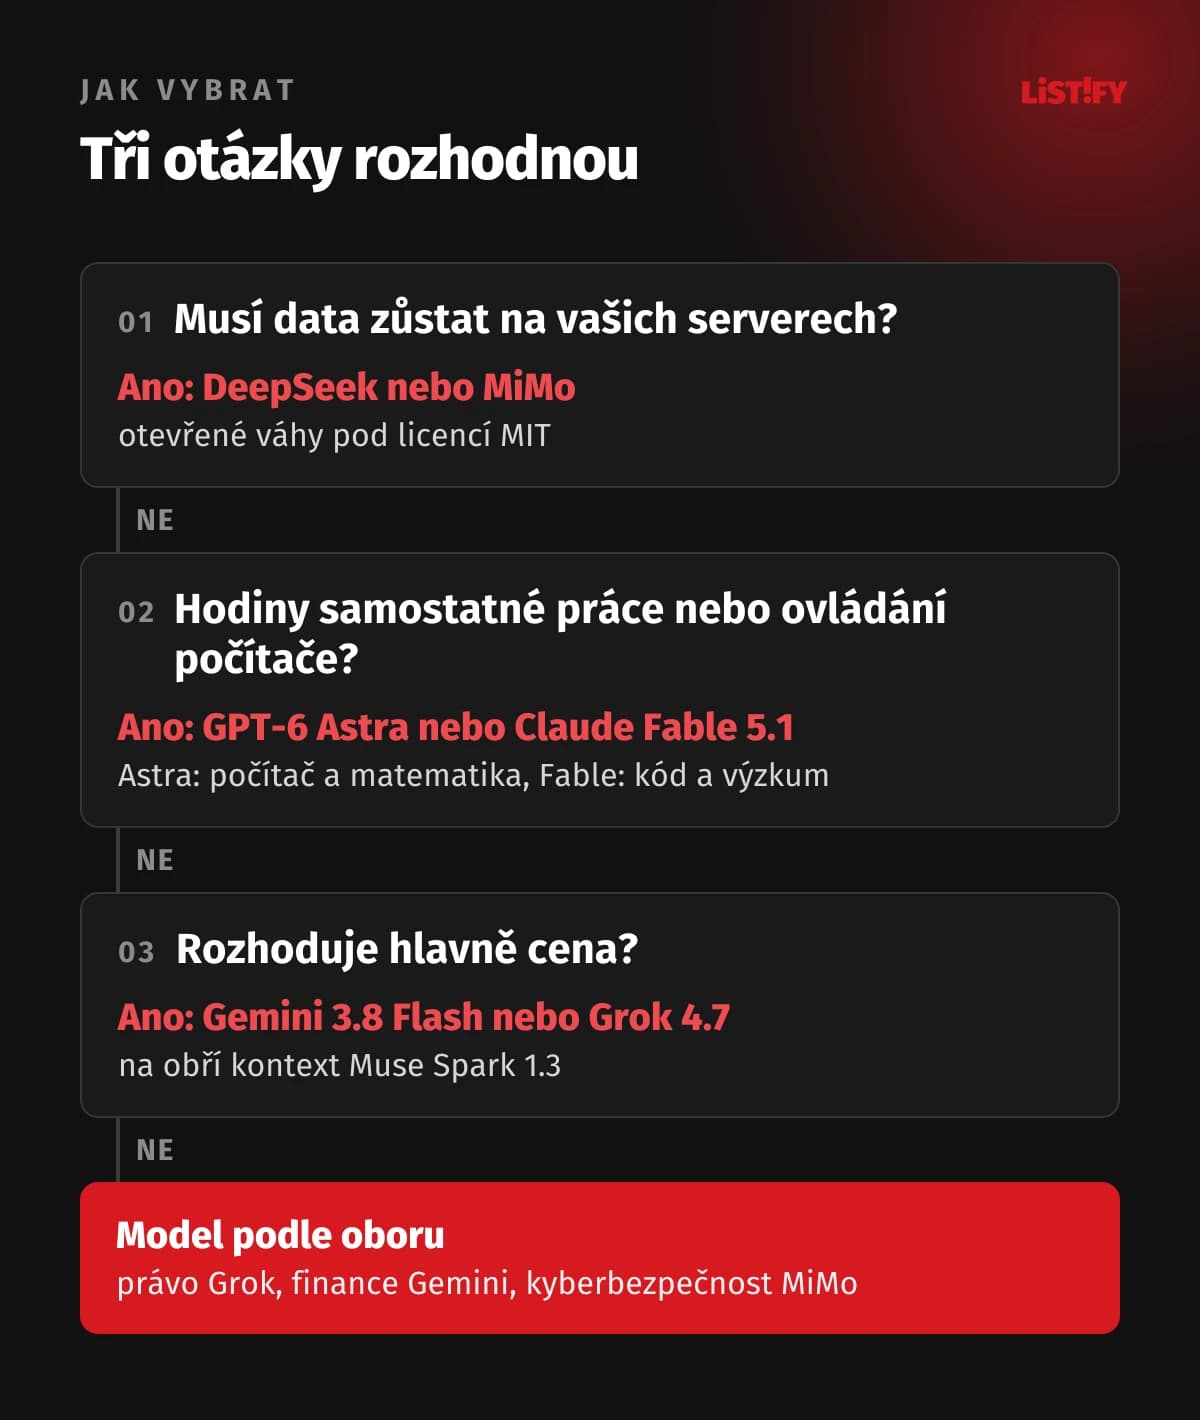
Nejlepší model na všechno neexistuje. Rozhoduje, co od něj potřebujete, a pomůžou vám tři otázky:
Doporučení podle scénáře
| Scénář | Doporučení | Proč |
|---|---|---|
| Automatizace práce v aplikacích bez API | GPT-6 Astra | 72,6 % v OSWorld 2.0, hotové prostředí ChatGPT Work |
| Velké změny kódu, noční agenti, výzkum | Claude Fable 5.1 | 53 bodů v AA indexu, silný v terminálu, levná cache |
| Matematika a vědecké výpočty | GPT-6 Astra | 97,6 % ve FrontierMath Tier 4 |
| Programovací agenti ve velkém a levně | Gemini 3.8 Flash nebo DeepSeek-V4.1-Flash | přes 73 % v DeepSWE za zlomek ceny |
| Analýza obřího repozitáře nebo dokumentů | Muse Spark 1.3 | 98,1 % v MRCR do 1 mil. tokenů, bez příplatku za dlouhý kontext |
| Právní a inženýrské agentní úlohy | Grok 4.7 | vede v Harvey Legal, v EEBench je druhý za GPT-6 Astra |
| Finance a biologie | Gemini 3.8 Flash | vede ve Vals Finance i LABBench2 |
| Data musí zůstat na vlastních serverech | DeepSeek-V4.1-Flash nebo MiMo V2.6 Pro | otevřené váhy pod licencí MIT |
| Text, obrázky, video i zvuk v jednom otevřeném modelu | MiMo V2.6 Pro | nativní podpora všech typů vstupu |
| Hledání zranitelností v kódu | MiMo V2.6 Pro nebo DeepSeek-V4.1-Flash | 94 % a 88,1 % v CyberGym (údaje výrobců) |
Než se rozhodnete, vyzkoušejte dva nebo tři kandidáty na vlastních úlohách a porovnejte cenu za přijatelnou odpověď. Pokud chcete AI zapojit do firemních procesů a nevíte, kde začít, pomůžeme s AI implementací.
14Časté otázky
Jaký je nejlepší AI model v září 2026?
Ze sedmi srovnávaných modelů mají v nezávislém Artificial Analysis Intelligence Index v4.3 nejvíc bodů GPT-6 Astra a Claude Fable 5.1, shodně 53. Astra vede v ovládání počítače a matematice, Fable 5.1 v Humanity’s Last Exam. Celý žebříček vede Claude Opus 5.5 (58 bodů), který vyšel 22. září.
Je lepší GPT-6 Astra, nebo Claude Fable 5.1?
Záleží na úloze. V indexu Artificial Analysis v4.3 mají oba 53 bodů. Astra vede v ovládání počítače (72,6 % v OSWorld 2.0), matematice a Terminal-Bench 4.0, Fable 5.1 v Humanity’s Last Exam. V API stojí oba stejně: 10 USD za milion vstupních a 50 USD za milion výstupních tokenů.
Který AI model je nejlevnější?
Ze srovnávaných modelů DeepSeek-V4.1-Flash mimo špičku (0,15 / 0,60 USD za milion tokenů). Ve špičce stojí 0,30 / 1,20 USD a levnější je MiMo V2.6 Pro (0,435 / 0,87 USD). Ještě levnější je menší MiMo V2.6 Flash za 0,14 / 0,28 USD.
Jaký je nejlepší open source AI model?
MiMo V2.6 Pro od Xiaomi. V Artificial Analysis Intelligence Index v4.3 má 46 bodů, nejvíc ze všech modelů s otevřenými váhami. DeepSeek-V4.1-Flash má 39 bodů, ale vyšší skóre v DeepSWE a nižší cenu mimo špičku.
Který AI model je nejlepší na programování?
V dlouhých softwarových úlohách jsou modely skoro vyrovnané: šest ze sedmi má v DeepSWE 71 až 75,4 %, Claude Fable 5.1 67,4 %. Na samostatnou práci v terminálu vedou GPT-6 Astra (57,9 %) a Claude Fable 5.1 (55,8 %) v Terminal-Bench 4.0.
Který model má největší kontextové okno?
GPT-6 Astra (1,05 milionu tokenů) a Muse Spark 1.3 (1 048 576 tokenů). Ostatní mají 1 milion, jen Grok 4.7 má 500 tisíc.
15Verdikt: trh se rozdělil na tři patra
Nahoře jsou GPT-6 Astra a Claude Fable 5.1. Z této sedmičky jen jim se dá svěřit několik hodin samostatné práce na počítači nebo v terminálu. Stojí ale 46krát víc než MiMo V2.6 Pro. Kdo chce podobnou inteligenci levněji, má od 22. září Claude Opus 5.5 za 4 / 20 USD.
Uprostřed jsou Gemini 3.8 Flash, Grok 4.7 a Muse Spark 1.3. V programování se vlajkovým modelům vyrovnají za sedminu až třináctinu ceny, na obecné agenty nestačí.
Cenově nejníž, ne kvalitou, jsou otevřené DeepSeek-V4.1-Flash a MiMo V2.6 Pro. V DeepSWE drží krok se špičkou, stojí zlomek a můžete je provozovat na vlastních serverech.
Většině firem se vyplatí kombinace: levný model na objem práce a vlajkový na nejtěžší úlohy. Trh se mění po týdnech, takže je rozumné nevázat se na jednoho výrobce.
16Zdroje
- OpenAI: GPT-6 Astra
- Anthropic: Claude Fable 5.1 a Mythos 5.1
- Anthropic: Claude Opus 5.5
- Agentpedia: Gemini 3.8 Flash
- Artificial Analysis: žebříček modelů
- xAI: Grok 4.7
- OpenRouter: Grok 4.7
- Meta: Muse Spark
- TrueFoundry: Muse Spark 1.3
- Hugging Face: DeepSeek-V4.1-Flash
- DeepSeek: ceník API
- MindStudio: DeepSeek-V4.1-Flash lokálně
- Xiaomi: MiMo-V2.6
- MindStudio: benchmarky GPT-6 Astra
- BenchLM: Gemini 3.8 Flash