Logování a observabilita: Metriky, logy a trasování
Server běží, ale zákazník nemůže dokončit objednávku. Graf procesoru to sám nevysvětlí. Observabilita má týmu umožnit rozpoznat dopad, najít související události a sledovat problém přes části systému, aniž by při každé chybě začínal sbírat data od nuly.
Když se uživatel ozve s problémem, tým potřebuje několik konkrétních odpovědí. Kdy to začalo? Koho se to týká? Který krok selhal? Souvisí to s posledním nasazením nebo externí službou? Nestačí mít spoustu logů uložených na serveru, pokud v nich nikdo nedokáže najít jednu problematickou operaci.
Pro menší aplikaci může stačit přehledné měření hlavních operací, strukturované záznamy a několik dobře připravených upozornění. S rostoucím počtem služeb přibývá potřeba sledovat průchod požadavku. Rozsah navrhujte podle provozních otázek a odpovědnosti týmu, nikoli podle počtu dostupných grafů.
01Každý signál odpovídá na jinou otázku
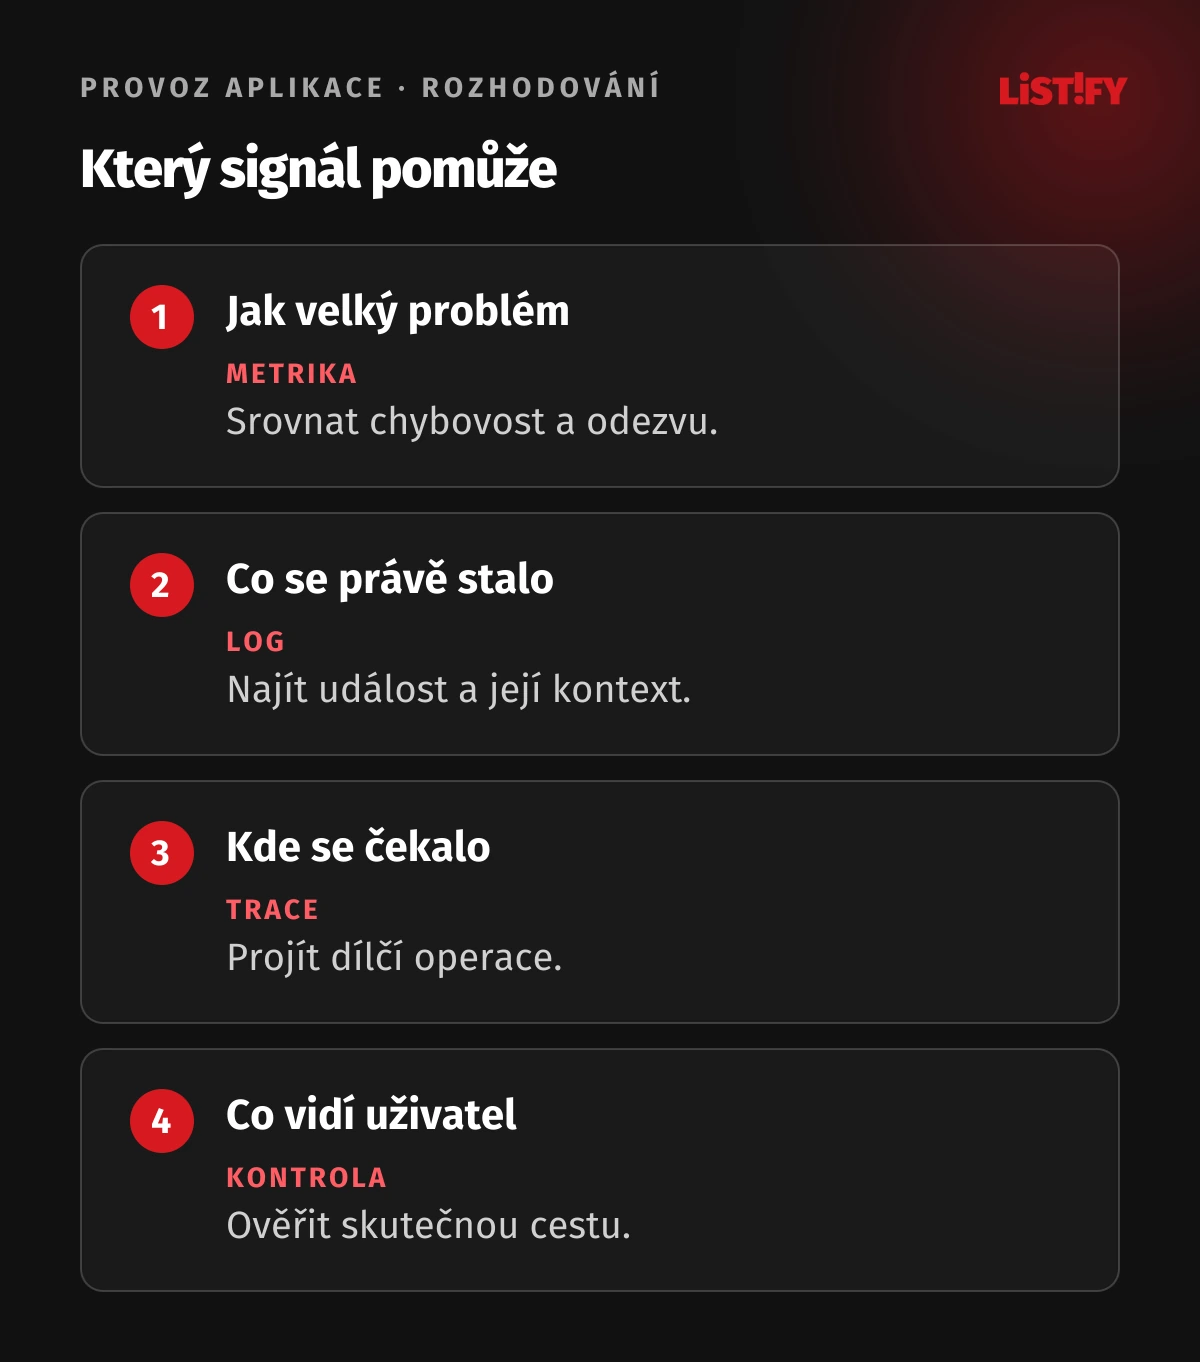
Metriky shrnují číselné chování systému v čase. Logy zaznamenávají jednotlivé události. Trasování zachycuje cestu konkrétního požadavku přes operace nebo služby. OpenTelemetry tyto signály popisuje jako různé pohledy na činnost aplikace. Největší praktický přínos vzniká, když z jednoho pohledu snadno přejdete do dalšího.
| Signál | Praktická otázka | Ilustrativní příklad |
|---|---|---|
| Metrika | Je problém rozsáhlý a od kdy? | Podíl neúspěšných vytvoření objednávky |
| Log | Co se stalo v konkrétním kroku? | Odmítnutí požadavku platební službou |
| Trace | Kde operace ztrácí čas? | Průchod API, databází a platbou |
| Kontrola zvenčí | Funguje očekávaná cesta? | Ověření dostupnosti přihlášení |
Observabilita znamená schopnost z dostupných výstupů klást otázky o chování systému a hledat příčiny. Samotná instalace nástroje tuto schopnost nezaručuje. Tým potřebuje vhodná data, společné názvy, propojení a znalost toho, co systém správně dělá. Zelený přehled infrastruktury může existovat současně s nefunkční obchodní operací.
02Začněte cestou uživatele a měřitelným cílem
Vyberte hlavní operaci: přihlášení, dokončení objednávky, uložení dokumentu nebo zpracování dávky. Popište úspěch tak, aby neznamenal pouze odpověď serveru. U uložení dokumentu například záleží i na tom, zda se skutečně uložený obsah dá znovu otevřít. Potom určete dobu měření, zdroj dat a přijatelné chování.
SLO je cíl kvality služby; SLI je ukazatel, kterým její chování měříte. V úvodu OpenTelemetry k observabilitě je důležitý pohled uživatele. Dostupný proces nemusí správně vykonávat jeho požadavek. Pro zadání proto napište vedle technické operace také její obchodní význam a vlastníka.
- Určete, co se počítá jako platný pokus a co jako úspěch.
- Oddělte očekávané odmítnutí od skutečné závady aplikace.
- Zapište hranici přijatelné odezvy pro konkrétní použití.
- Dohodněte, kdo reaguje a jak rychle podle provozních potřeb.
Neodvozujte cíle pouze z hezkého procenta v prezentaci. Firma musí vědět, co omezení znamená pro zákazníky, provozní tým a náklady. U interního systému může být zásadní dokončení ranní dávky před začátkem směny. U veřejné aplikace zase dostupnost konkrétní cesty i mimo pracovní dobu.
03Spojte události přes společný kontext
K logu přidejte čas, název služby, prostředí, verzi nasazení, závažnost a typ události. Používejte strukturovaná pole, která lze spolehlivě filtrovat. Volná zpráva může vysvětlovat kontext, ale zásadní údaje nemají být schované jen uvnitř věty, kterou každý vývojář napíše jinak.
Pro sledování jedné operace přenášejte identifikátor požadavku nebo trasování. Trace se skládá ze spanů, tedy zaznamenaných dílčích operací. Užitečný pohled ukáže, která část čekala na databázi a která na jinou službu. Propojení logu s trace pomůže přejít od celkové doby ke konkrétní chybové události.
Zvláštní pozornost věnujte frontám a úlohám na pozadí. Odeslání do fronty nemusí znamenat úspěšné dokončení práce. Potřebujete rozlišit přijetí, začátek zpracování, dokončení a opakování. Kontext přeneste i přes tuto hranici. Při propojení systémů přes API domluvte, které identifikátory si služby předají a kdo umí dohledat protistranu.
Ověřte záznam z obou konců jedné operace. Chybějící kontext může vytvořit několik izolovaných stop, které vypadají jako samostatné požadavky. Sjednoťte časovou synchronizaci a zobrazované časové pásmo, aby tým nespojoval události jen podle podobné minuty v různých prostředích.
04Metriky stavte kolem dopadu a kapacity
Google SRE doporučuje čtyři základní signály: odezvu, provoz, chyby a vytížení omezených zdrojů. Pro aplikaci tak můžete sledovat dobu důležité operace, počet pokusů, jejich neúspěšný podíl a zaplnění fronty. Konkrétní metriky vybírejte podle toho, co skutečně omezuje službu.
Průměrná odezva může skrýt pomalou část požadavků. Sledujte rozdělení nebo zvolený percentil a napište, co znamená. Například 95. percentil vyjadřuje hodnotu, pod kterou se ve vyhodnoceném souboru nachází přibližně 95 procent měření. Nejde o procento dostupnosti. Rozlišujte dobu úspěšných a chybových operací; rychlá chybová odpověď není dobrá zkušenost.
Hlídání vytížení má praktický význam, pokud odhalí blížící se omezení. Místo jediného grafu CPU mohou být důležité čekající úlohy, volné místo nebo počet dostupných spojení. Když vidíte růst fronty, zkontrolujte také rychlost jejího odbavení. Samotný počet položek bez znalosti běžného provozu neříká, zda systém stíhá.
05Alert musí vést k rozhodnutí
U každého upozornění napište dopad, vlastníka a první krok. Zpráva „chyba v aplikaci“ je slabá. Užitečnější je informace, že hlavní operace překračuje domluvenou chybovost, které prostředí je postižené a kde se otevře související přehled. Přidejte odkaz na stručný provozní postup a způsob předání, pokud první člověk příčinu nevyřeší.
Rozlišujte upozornění na přehled, úkol k řešení v pracovní době a naléhavý incident. Ne každá výjimka musí vzbudit člověka. Google SRE v citované kapitole zdůrazňuje, že naléhavé upozornění má umožnit konkrétní reakci. Při navrhování ověřte také délku problému, minimální objem a známé situace, ve kterých pravidlo vyvolává zbytečný poplach.
Alert otestujte od vyvolání podmínky až po doručení odpovědnému člověku. Ověřte eskalaci i oznámení návratu do normálu. Po incidentu upravte pravidla podle zkušenosti: co chybělo, co se opakovalo a co pouze odvádělo pozornost. Opakovaná ruční reakce je podnět k opravě příčiny nebo bezpečné automatizaci, ne k dalšímu kopírování upozornění.
Provozní postup držte krátký a dostupný i při výpadku sledované aplikace. Má obsahovat způsob ověření dopadu, bezpečné možnosti omezení problému a kontakt pro eskalaci. Rozlišujte diagnostiku od zásahů, které mohou změnit nebo ztratit data. Nový kolega musí vědět, co může provést samostatně a kdy zapojit vlastníka služby. Při aktualizaci aplikace zkontrolujte také odkazy a názvy, na které alert odkazuje.
06Chraňte data a kontrolujte jejich objem
Logování může nechtěně vytvořit další úložiště citlivých informací. OWASP Logging Cheat Sheet upozorňuje na hesla, přístupové tokeny, klíče i citlivé osobní údaje. Nenahrávejte automaticky celé tělo požadavku nebo autorizační hlavičky. Nastavte povolená pole a odstraňování citlivého obsahu už při vzniku záznamu.
Stanovte, kdo data čte, jak dlouho se uchovávají a jak se mažou. Oddělte prostředí a přístupy. Při exportu k dodavateli zkontrolujte účel, smluvní vztah a místo zpracování. Maskování není automatickou zárukou anonymity. Provozní log, bezpečnostní záznam a účetní evidence mohou mít různé účely i retenční požadavky. Navazuje na ně bezpečnost dat v systému na míru.
Objem metrik závisí také na počtu kombinací štítků. Prometheus varuje před hodnotami s velkým nebo neomezeným počtem variant, například uživatelskými ID a e-maily. Pro metriku použijte omezené kategorie, jako typ operace. Jednotlivý požadavek dohledávejte v odpovídajícím logu či trace, kde máte nastavený přístup a retenci.
U trasování lze vybírat jen část stop. Dokumentace OpenTelemetry k samplingu popisuje úsporu objemu i riziko ztráty potřebných informací. Výběr na začátku požadavku nemůže vycházet z chyby, která se objeví později. Strategii proto ověřte na běžných i problematických operacích a zapište, co vyhodnocení nezachytí.
07Zaveďte observabilitu na jednom scénáři
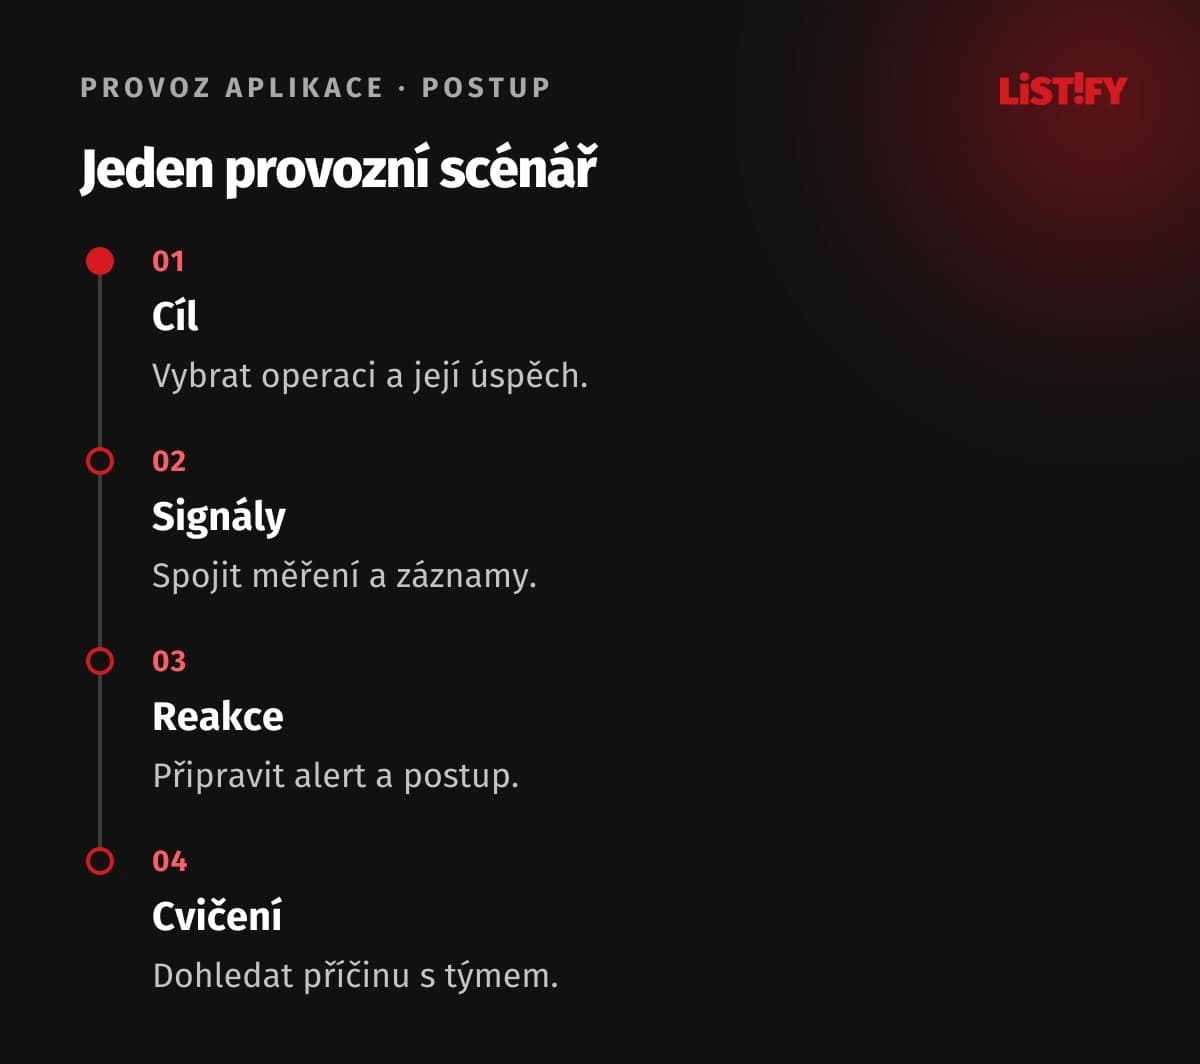
Vyberte operaci, se kterou má tým opakovaný problém nebo vysokou provozní odpovědnost. Nakreslete její cestu a přiřaďte potřebné signály. Definujte názvy událostí, kontext, bezpečná pole a cílový přehled. Potom v kontrolovaném prostředí vyvolejte typické situace, například chybu závislosti, zpomalení nebo neúspěšné zpracování úlohy.
- Popište úspěch a dopad selhání vybrané operace.
- Zprovozněte metriku a propojené záznamy se společným kontextem.
- Prověřte dohledání příčiny, alert a provozní postup.
- Vyhodnoťte užitečnost, objem dat a potřebné rozšíření.
Při cvičení nechte kolegu, který měření nenavrhoval, najít incident jen s běžnými přístupy. Zjistíte, zda je přehled srozumitelný a postup proveditelný. Úspěšná instalace agenta nebo odeslaný testovací log jsou pouze dílčí výsledky. Rozhoduje schopnost reagovat na očekávaný problém a rozpoznat, která data ještě chybějí.
Do přejímky zahrňte také poruchu samotného sběru. Když přestanou přicházet data, přehled nesmí vytvářet dojem bezchybného provozu. Rozlišujte skutečnou nulu a chybějící měření. Zkontrolujte chování při nedostupném cílovém úložišti, zaplnění místní fronty a omezeném připojení. Dohodněte, jak výpadek poznáte a které části diagnostiky zůstanou dostupné. To je zvlášť důležité, pokud aplikace i nástroj pro dohled sdílejí stejnou infrastrukturu.
08Časté otázky k observabilitě
Stačí sledovat dostupnost serveru?
Dostupnost infrastruktury je jen část obrazu. Sledujte také úspěch důležitých operací a jejich odezvu. Server může odpovídat, zatímco aplikace ukládá špatná data nebo nefunguje její závislost.
Jaký je rozdíl mezi logem a trasováním?
Log je záznam události. Trace spojuje dílčí operace do cesty jednoho požadavku. Log s identifikátorem trace umožní přejít od pomalé operace ke konkrétní chybě nebo rozhodnutí aplikace.
Má malý systém zavádět všechny nástroje?
Rozsah volte podle otázek a rizik provozu. Začněte hlavní operací, základními metrikami a dohledatelnými záznamy. Přidávejte další části, když řeší skutečnou potřebu a tým je dokáže používat.
Je OpenTelemetry hotový monitoring?
OpenTelemetry poskytuje prostředky pro vznik, sběr a export telemetrie. Pro její ukládání, zobrazení a provozní reakci potřebujete odpovídající řešení a proces. Konkrétní schopnosti závisí na použitém prostředí a komponentách.
Můžeme ukládat kompletní požadavky?
Takové logování snadno zachytí hesla, tokeny nebo osobní údaje. Vybírejte potřebná bezpečná pole, stanovte účel a retenci a kontrolujte přístupy. Detailní diagnostiku navrhujte cíleně, nikoli jako trvalý neomezený sběr.
Proč nepoužít ID zákazníka jako štítek metriky?
Každá unikátní kombinace štítků vytváří další časovou řadu. Velké množství ID může výrazně zvýšit objem a náklady. Pro souhrnné metriky volte omezené kategorie a jednotlivé případy dohledávejte jiným vhodným signálem.
Jak poznáme, že zavedení pomohlo?
Ověřte, zda tým rozpozná dopad, dohledá související operaci a provede první reakci. Sledujte také zbytečné alerty, chybějící data a provozní náklady. Samotný počet grafů nevypovídá o schopnosti řešit incidenty.