Zálohování a disaster recovery plán: Co dělat, když se server zhroutí
Při pádu serveru potřebujete obnovit práci firmy, ne jen zapnout náhradní stroj. Disaster recovery plán určuje, kdo rozhodne o obnově, z jakého stavu se začne a podle čeho lze znovu pustit uživatele. Ukážeme, jak připravit použitelný postup od prvního hlášení po bezpečný návrat do běžného provozu.
Zálohy existují, nový server je připravený, ale aplikace stále nefunguje. Chybí přístup k DNS, klíč je uložený na nedostupném systému a nikdo neví, zda už některé objednávky odešly do skladu. Podobný modelový scénář vysvětluje rozdíl mezi kopií dat a plánem obnovy celé služby.
Principy uchování a ochrany kopií popisujeme v článku zálohování 3-2-1 a ověřená obnova. Tady navazujeme operačním postupem: kdo kdy co ověří, v jakém pořadí se obnoví závislosti a jak se firma rozhodne, že může pokračovat.
01Nejdřív určete, jaký typ výpadku řešíte
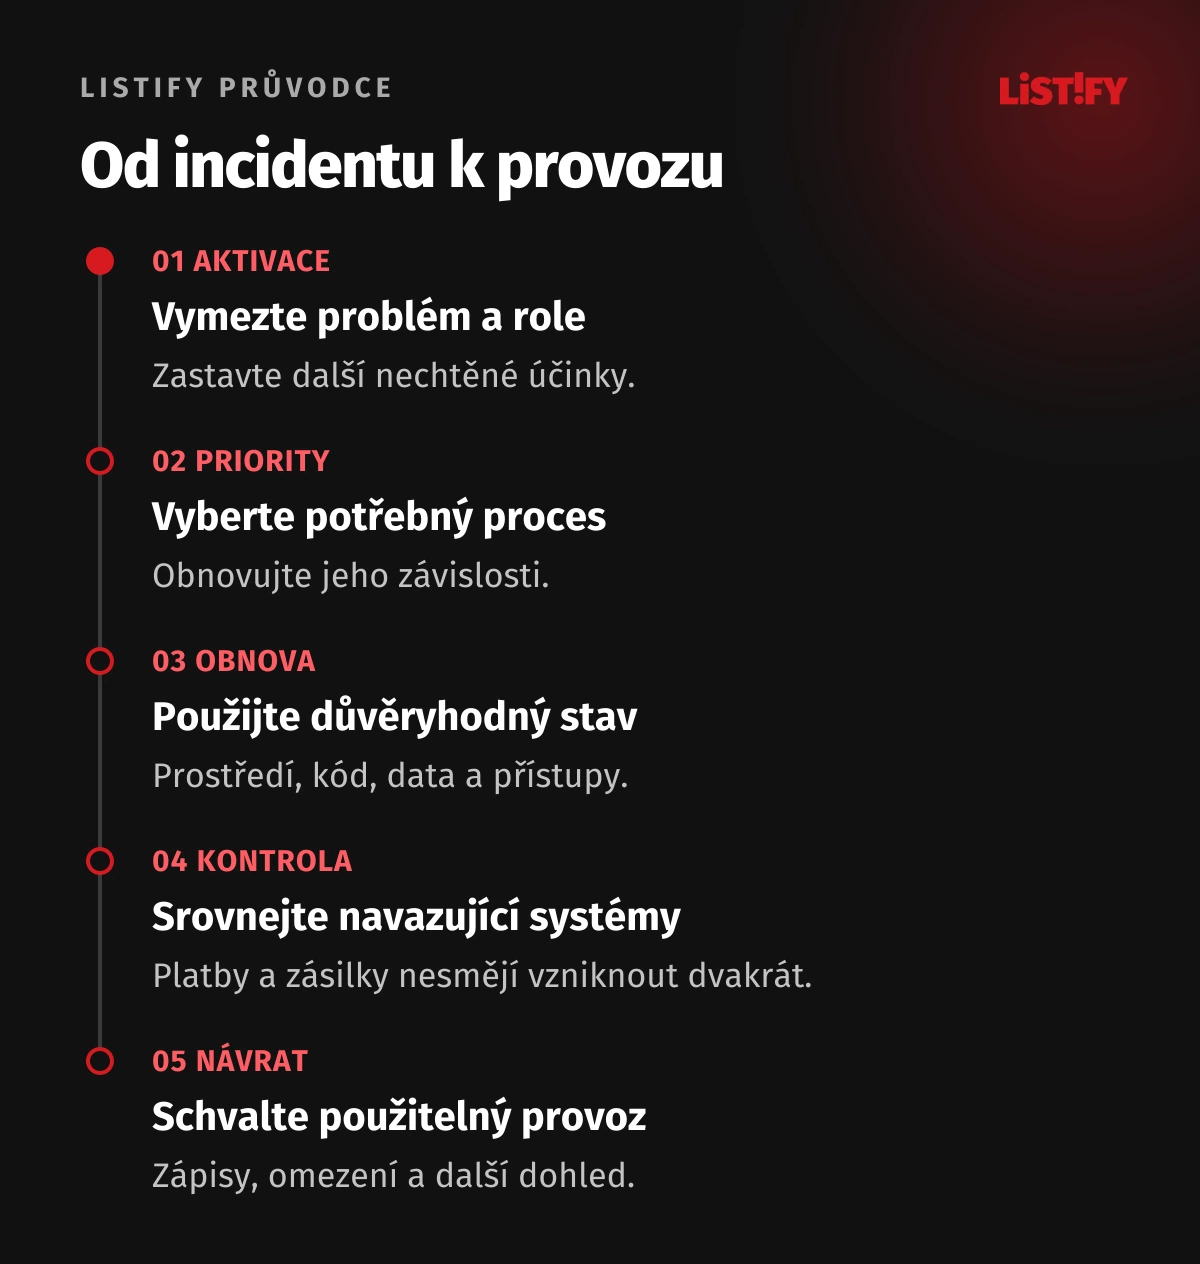
Nedostupná aplikace může znamenat chybu vydání, poruchu stroje, výpadek poskytovatele i napadení. Stejná reakce na všechny příčiny není vhodná. Plán má obsahovat podmínku aktivace, odpovědného koordinátora a první bezpečné zjištění rozsahu. Určete, zda zastavit nové zápisy a navazující automatizace, aby se problém dále nešířil.
Při podezření na útok technický tým současně řeší omezení napadení a důkazy. Kanadské Cyber Centre v ransomware playbooku doporučuje oddělení postižených systémů a obnovu do čistého izolovaného prostředí. Obnovení zálohy do stále napadené služby neodstraní příčinu. Konkrétní zásahy musí řídit lidé s odpovědností za incident.
02Jeden koordinátor, společný záznam, dostupné kontakty
Koordinátor drží přehled rozhodnutí a rozděluje práci, nemusí sám obnovovat databázi. Určete technického vedoucího, vlastníka obchodního procesu a člověka pro komunikaci. I v malém týmu si řekněte, kdo může schválit náhradní infrastrukturu, pozastavení služby nebo návrat k dřívějším datům.
Založte časovou osu: zjištění problému, poslední známý dobrý stav, provedené zásahy a další rozhodnutí. Dokumentace a kontakty musí být dostupné i při výpadku hlavního přihlášení či e-mailu. Nouzový přístup ověřte předem a omezte na oprávněné osoby. Bezpečné zacházení s klíči řeší správa tajemství a konfigurace.
03Pořadí obnovy vychází z minimálního použitelného provozu
Vyberte, co musí firma dělat jako první. U modelového velkoobchodu může být prioritou dohledat již zaplacené objednávky a předat je skladu. Nové objednávky, doporučování produktů a historické reporty mohou mít jiné pořadí. Není ale možné obnovit objednávkovou obrazovku bez databáze, identit a potřebných souborů.
| Vrstva nebo schopnost | Co musí být připravené | Jak se ověří |
|---|---|---|
| Řízení obnovy | Kontakty, přístupy a schválená rozhodnutí. | Náhradní tým se dostane k postupu. |
| Základ prostředí | Síť, identity, konfigurace a potřebná kapacita. | Oprávněný přístup a omezené propojení. |
| Data a hlavní aplikace | Zvolený konzistentní stav a kompatibilní verze. | Vybrané záznamy a pracovní scénář. |
| Navazující služby | Zkontrolované fronty, platby a předání skladu. | Shoda stavů bez druhých účinků. |
NIST SP 800-34 poskytuje rámec plánování obnovy a priorit systémů. Pro firmu jej převeďte na konkrétní závislosti; samotný seznam serverů obchodní pořadí nevyřeší.
04Zvolte bod obnovy a přiznejte, co v něm chybí
RPO popisuje požadovaný bod obnovy a tolerovanou ztrátu novějších změn, RTO časový cíl návratu potřebné služby. V plánu oddělte cíle od výsledků poslední zkoušky. Záloha vytvořená nedávno ještě není jistě vhodná: může obsahovat poškození nebo stav, který nesouhlasí s připojenými soubory.
Při rozhodnutí evidujte datum kopie, důvod výběru a známé mezery. U útoku může být vhodnější starší důvěryhodný stav než nejnovější kopie. Obchodní vlastník musí vědět, které novější operace bude potřeba dohledat. Způsob ochrany a dostupnost dat v prostředí dodavatele doplňuje bezpečnost v cloudu.
05Obnovte celé prostředí podle připraveného postupu
Postup má jmenovat potřebné verze aplikace, konfiguraci, úložiště, databázi, identity a návaznosti. U každého kroku napište předpoklad a výsledek, podle kterého lze pokračovat. Pokud jsou přístupy, šifrovací klíče nebo postup sestavení dostupné jen uvnitř ztraceného serveru, není plán proveditelný.
AWS v přehledu disaster recovery rozlišuje obnovu ze záloh a připravená náhradní prostředí. Vedle dat počítá s konfigurací, kódem a infrastrukturou. Vyšší připravenost má vlastní náklady; článek neslibuje konkrétní čas obnovy pro vaši aplikaci.
Před zpřístupněním prověřte pravidla sítě, certifikáty a administrátorské účty. Náhradní prostředí nesmí být bezpečnostně slabší jen proto, že vzniklo narychlo. Základní kontrolu nabízí zabezpečení serveru, HTTPS a cloudu.
06Srovnejte stav s tím, co už proběhlo jinde
Obnovená databáze může ukazovat nezaplacenou objednávku, jejíž platbu brána již přijala. Sklad mohl zásilku vyexpedovat, přestože lokální potvrzení v záloze chybí. Proto nespouštějte všechny fronty, e-maily a opakované úlohy bez posouzení. Nejdříve stanovte, které položky jsou jisté, které čekají a které vyžadují dohledání.
Pro párování použijte stabilní identifikátory, záznamy partnerů a dohodnuté kontrolní součty. Oprava má být dohledatelná a nesmí znovu spustit platbu nebo expedici. Přípravu těchto pravidel vysvětluje propojení systémů přes API. Ztracený lokální stav neznamená, že externí operace nikdy neproběhla.
07Návrat služby schvalujte po konkrétních kontrolách
| Rozhodnutí | Požadovaný podklad | Kdo potvrzuje |
|---|---|---|
| Povolit interní kontrolu | Prostředí je připravené a oddělené od nechtěných účinků. | Technický vedoucí. |
| Povolit vybraný pracovní proces | Data a návaznosti odpovídají ověřenému scénáři. | Technický tým a vlastník procesu. |
| Povolit nové zápisy | Je jednoznačné, kam se zapisuje a jak se řeší mezery. | Odpovědný provozní vlastník. |
| Ukončit nouzový režim | Zbývající omezení mají vlastníky a běžný dohled funguje. | Koordinátor s vlastníky služby. |
Nestačí přihlášení správce. Předveďte například otevření správné objednávky, její oprávněnou změnu a předání do navazujícího systému. Upozorněte uživatele na známá omezení a nastavte častější kontrolu po otevření. Nejasný výsledek je důvodem zůstat v omezeném režimu, nikoli přepsat přejímací podmínku.
08Náhradní práce a návrat z náhradního prostředí
Pokud firma dočasně přijímá požadavky jinou cestou, určete jejich evidenci, vlastníka a pozdější vložení do systému. Každý případ potřebuje identifikátor a stav. Volně sdílené tabulky bez pravidel mohou při obnově vytvořit další duplicity a nesoulad. Zákazníkům sdělujte, které služby fungují a kdy dostanou další informaci; neodhadujte čas opravy bez podkladů.
Také návrat z náhradního prostředí je změna. Rozhodněte, které místo je hlavním zdrojem zápisů, přeneste novější data a ověřte rozdíly před přepnutím. Neponechávejte dva nezávislé zapisující systémy bez navrženého řešení konfliktů. Původní server není automaticky autoritativní jen proto, že znovu naběhl.
09Cvičení má odhalit čekání, nejen změřit kopírování
Naplánujte schválenou zkoušku bez dopadu na zákazníky. Vyberte scénář a podmínky: hlavní správce není dostupný, původní účet nelze použít nebo je potřeba jiný stroj. Měřte čas od zahájení podle domluvené definice až k použitelnému procesu. Zvlášť evidujte čekání na rozhodnutí, přístupy, data a obchodní kontrolu.
Výstupem jsou skutečné dosažené výsledky, mezery a úkoly s vlastníky. Po změně aplikace, dat nebo dodavatele posuďte, co znovu ověřit. Test nemůže potvrdit všechny druhy havárie najednou. V rámci servisu a správy lze s Listify vymezit plán obnovy aplikace a konkrétní zkoušku podle jejího stavu.
10Časté otázky k disaster recovery
Je disaster recovery totéž jako zálohování?
Ne. Zálohování vytváří dostupné kopie potřebných dat. Plán obnovy navíc řeší lidi, přístupy, náhradní prostředí, pořadí kroků a ověření použitelné služby. Bez těchto částí mohou kopie existovat, ale firma zůstane stát.
Stačí druhý server ve stejném prostředí?
Může pomoci u určité poruchy. Nemusí pomoci při poškození dat, napadení společného účtu nebo výpadku společné závislosti. Návrh porovnejte se scénáři, které má skutečně pokrývat, a s požadovanou dobou obnovy.
Kdo rozhodne, že můžeme znovu pracovat?
Technický tým ověří prostředí, vlastník procesu použitelnost dat a práce. Koordinátor zajistí, aby šlo o společné rozhodnutí se známými omezeními. Předem určete také osobu oprávněnou povolit nové zápisy.
Musíme obnovit všechno najednou?
Nemusíte. Smysl může mít nejprve omezený provoz nejdůležitějšího procesu. Musí však fungovat jeho nezbytné závislosti a být jasné, co zatím není dostupné. Pořadí určete podle dopadu na firmu a ověřte zkouškou.
Co dodat pro přípravu DR plánu?
Seznam hlavních procesů, systémů a dodavatelů, přehled záloh a odpovědných lidí. Doplňte, jak dlouho může firma stát a jaké změny si může dovolit ztratit. Neznámé odpovědi označte; úvodní kontakt nevyžaduje hesla ani kopii databáze.