Škálovanie aplikácie: čo robiť, keď pribúdajú používatelia
Keď aplikácia rastie, rozširujte kapacitu podľa nameraného obmedzenia a počítajte aj s výpadkom časti systému. Samotný počet registrovaných účtov vám nepovie, čo treba kúpiť. Potrebujete poznať špičkovú záťaž, požadovanú kvalitu služby, overenú prevádzkovú hranicu a termín ďalšieho rastu. Ukážeme, ako z týchto údajov zostaviť kapacitný plán, podľa ktorého sa dohodne vedenie firmy, obchod aj vývojári. Od najbližšej kampane cez záťažový test až po rozhodnutie o investícii.
Aplikácia má zákazníkov, prevádzka rastie a podpora začína počúvať, že sa v najvyťaženejšej hodine pracuje pomaly. Obchod pritom privádza ďalšieho veľkého klienta a marketing má objednanú kampaň. Potrebujete vedieť, či ich systém zvládne. Zoznam možných serverov a databáz vám takúto odpoveď nedá.
Výsledkom má byť krátky kapacitný plán s predpokladmi, meraním, termínom rozhodnutia a konkrétnou zodpovednou osobou. Technické podklady sme overili 23. októbra 2026. Čísla v modelovom príklade nepochádzajú z merania klienta LISTIFY. Základy architektúry rozoberá samostatný článok o škálovateľnosti webovej aplikácie. Tu riešime prevádzku, ktorá už skutočne rastie.
01Začnite operáciou, ktorá musí zostať funkčná
Najprv pomenujte, na čo aplikácia slúži. Dokončenie rezervácie, odoslanie objednávky, otvorenie zákazníckej karty alebo uloženie pracovného výkazu. Pri tejto operácii opíšte úspešný výsledok. Rýchla chybová stránka nie je fungujúca služba a dvakrát prijatá objednávka nie je výkonnostný úspech.
Dohodnite si merateľný cieľ služby. Môže určovať podiel úspešne dokončených operácií v určitom čase, sledované obdobie a prijateľnú chybovosť. Konkrétne limity musia zodpovedať produktu a očakávaniam zákazníkov. Export na pozadí môže mať iný časový rozpočet než potvrdenie platby alebo dostupnosti rezervovaného termínu.
Doplňte obchodný dôsledok nesplnenia cieľa. Spôsobí pomalá odozva telefonát na podporu, zastaví skladníka alebo znemožní nákup? Tím tak vie, ktorú operáciu chrániť ako prvú. Vedenie zasa rozlíši potrebnú investíciu od drahého zlepšovania ukazovateľa, ktorý zákazníkom nič podstatné neprinesie.
02Rast opíšte ako prácu, ktorú systém dostáva
Oddeľte registrované účty, aktívne relácie, požiadavky a náročné úlohy. Desať nových klientov s veľkým importom katalógu môže vytvoriť väčšiu záťaž než tisíc príležitostných čitateľov. Zaznamenajte najvyťaženejšie relevantné intervaly aj skladbu činností. Čítanie, zápisy, vyhľadávanie, importy a exporty by nemali zmiznúť v jednom súhrnnom čísle.
Spýtajte sa obchodu a marketingu, čo sa zmení. Nová zmluva môže znamenať pravidelný ranný import. Kampaň privedie ľudí na rovnaké vyhľadávanie bez vyrovnávacej pamäte. Nová funkcia pridá ku každej požiadavke ďalší databázový dotaz. Aj pri rovnakom raste mesačne aktívnych používateľov tak vznikajú rozdielne nároky na kapacitu.
Vytvorte jednoduchý zoznam: zdroj rastu, dátum, dotknutá operácia, pravdepodobné rozpätie a miera istoty. Podpísané nasadenie klienta odlíšte od obchodného želania. Keď sa termín posunie, zmeníte konkrétny predpoklad. Nemusíte prepisovať celý plán ani predstierať, že pôvodný odhad bol presnou predpoveďou budúcnosti.
03Zmerajte východiskový stav v čase problému
Začnite prevádzkou, latenciou, chybami a nasýtením zdrojov, teda štyrmi signálmi z príručky Google SRE. Výsledky rozdeľte podľa dôležitej operácie a úspechu či neúspechu. Pridajte verziu aplikácie, veľkosť databázy a udalosti nasadenia, aby náhla zmena mala kontext.
Vedenie potrebuje z východiskového merania pochopiť tri veci: čo zažíva zákazník, koľko užitočnej práce sa dokončí a kde ubúda rezerva. Vyťaženie procesora pomôže, ale skutočným obmedzením môže byť čakanie na spojenie, pamäť, vek úloh vo fronte alebo limit dodávateľského API. Pokojný aplikačný server nezaručuje voľnú kapacitu celej služby.
Používajte rovnaké definície v monitoringu aj pri teste. Ak produkcia meria dokončené rezervácie a test len odoslané požiadavky, čísla nepodporujú rovnaké rozhodnutie. Zahrňte reprezentatívnu špičku a uchovajte rozdelenie odoziev. Mesačný priemer ľahko skryje krátke obdobie, v ktorom vzniká väčšina zákazníckych sťažností.
04Hľadajte použiteľnú hranicu, nie okamih pádu
Využiteľná kapacita je záťaž, pri ktorej sledovaná operácia za opísaných podmienok ešte plní dohodnutý cieľ. Nie je to posledná požiadavka, ktorú server vybaví pred zlyhaním. Záťaž zvyšujte po kontrolovaných krokoch, sledujte ustálenie prevádzky a zastavte test pri prekročení vopred určenej hranice odozvy, chybovosti alebo bezpečnosti.
Napodobnite dôležité vlastnosti produkcie: objem a rozloženie údajov, oprávnenia používateľov, zahriatu aj prázdnu vyrovnávaciu pamäť a pomer čítania k zápisom. Rozdiely, ktoré neviete reprodukovať, výslovne zapíšte. Databáza s niekoľkými riadkami overí funkčnosť testovacieho scenára. Nepreukáže kapacitu aplikácie u veľkého zákazníka s niekoľkoročnou históriou.
Rozsah testu dohodnite so správcom prostredia. Testovacie správy, platby a externé požiadavky nesmú omylom zasiahnuť skutočných príjemcov. Určte podmienku zastavenia aj postup návratu do normálu. Výstupom je opakovateľný výsledok s konfiguráciou a obmedzeniami, nie pôsobivá snímka obrazovky s vysokým počtom požiadaviek.
05Model kapacity má odhaliť konkrétne rozhodnutie
Uvažujme o fiktívnej aplikácii s dnešnou špičkou 120 požiadaviek za sekundu. Tím očakáva rast o 25 % a predpokladá, že kampaň túto budúcu špičku vynásobí koeficientom 1,4. Plánovaný scenár je teda 120 × 1,25 × 1,4 = 210 požiadaviek za sekundu. Ide o zvolené predpoklady na vysvetlenie postupu.
- Dnešná špička120
- Po raste o 25 %150
- Rast a kampaň210
- Kapacita: štyri inštancie260
- Kapacita: jedna inštancia mimo prevádzky190
Modelový plán, nie benchmark ani výsledok klienta. Dopyt: 120 × 1,25 × 1,4 = 210 požiadaviek/s. Obe kapacity sú samostatné predpokladané výsledky testu s rovnakou skladbou prevádzky a cieľmi služby, nie lineárny prepočet.
Predstavme si dva samostatné testy rovnakej skladby prevádzky a rovnakého cieľa služby. So štyrmi inštanciami vyjde využiteľná kapacita 260 požiadaviek za sekundu, s jednou nedostupnou inštanciou 190. Obe hodnoty sú v tomto článku modelové. Nižšie číslo nevzniká odpočítaním štvrtiny vyššieho: zdieľané závislosti takýto prepočet spochybňujú.
Bežná konfigurácia zdanlivo stačí, ale plán kampane prekračuje kapacitu pri výpadku o 20 požiadaviek za sekundu. Práve to má model odhaliť. Môžete overene rozšíriť kapacitu, rozložiť príchody, odložiť menej dôležité úlohy alebo vedome prijať opísané riziko. Samotné tvrdenie „máme ešte rezervu 50 požiadaviek“ by výpadkový scenár zakrylo.
06Rezerva musí pokryť aj údržbu a výpadok
Plán postavený na stopercentnej dostupnosti všetkých súčastí nepočíta s nasadením, nefunkčnou inštanciou ani pravidelnou údržbou. Určte, akú poruchu má služba zvládnuť. Výpadok jedného aplikačného procesu, prepnutie databázy a nedostupnosť celého regiónu sú rôzne zadania s výrazne odlišnými nákladmi.
Vo zvolenom scenári skontrolujte celý reťazec. Viac aplikačných inštancií môže otvoriť priveľa databázových spojení. Presunutá prevádzka môže preťažiť náhradný cieľ. Dlhší front môže oddialiť chybové hlášky, kým zákazníci čakajú stále dlhšie. Čas návratu k normálnej službe je rovnako dôležitý ako samotné opätovné spustenie procesu.
Veľkosť rezervy nechajte vedome schváliť ako obchodné rozhodnutie. Má zodpovedať následkom prerušenia a času potrebnému na pridanie kapacity. Univerzálne správne percento neexistuje. Predpoklady nechajte viditeľné, aby sa k nim tím mohol vrátiť po vydaní funkcie, nástupe veľkého zákazníka alebo zmene limitov dodávateľa.
07Vyberte najmenší zásah, ktorý rieši obmedzenie
Pred návrhom upgradu žiadajte diagnózu. Ak brzdí pomalý dotaz, ďalšie aplikačné procesy môžu situáciu zhoršiť. Ak aplikácia vyčerpáva výpočtový výkon a databáza má rezervu, viac procesov môže pomôcť. Ak priepustnosť obmedzuje zmluvná kvóta partnera, nákup vlastných serverov ju nezvýši.
| Čo ukazuje meranie | Možný zásah | Čo treba overiť |
|---|---|---|
| Záťaži dominuje jedna drahá operácia | Obmedziť jej prácu alebo vhodnú časť odložiť | Správnosť, čas dokončenia a zostávajúce obmedzenie |
| Aplikačné procesy sú vyťažené, závislosti majú rezervu | Zvýšiť výkon alebo počet procesov | Relácie, rozpočet spojení a správanie pri výpadku |
| Prevažuje čakanie na databázu | Upraviť dotazy, indexy alebo kapacitu databázy | Zápisy, zámky a reprezentatívne údaje |
| Priepustnosť obmedzuje cudzie API | Dohodnúť kvótu, riadiť tempo alebo zmeniť postup | Podmienky partnera, vek frontu a informácie používateľovi |
| Krátka známa špička prekračuje kapacitu | Navýšiť vopred a rozložiť príchody | Zahriatie, nákladový strop a návrat do normálu |
Každý návrh má uviesť očakávaný prínos, meranie, ktoré ho môže vyvrátiť, prevádzkové náklady a cestu späť. Menšiu zmenu s jasným overením posúdite ľahšie než všeobecné prepísanie systému zdôvodnené budúcim rastom. Rozsiahlejšia zmena architektúry môže byť správna, potrebuje však konkrétne obmedzenie a realistický plán dodania.
Podrobný postup na rozlíšenie problémov databázy, API a prehliadača nájdete v článku o výkone webovej aplikácie.
08Automatické škálovanie má vlastné oneskorenie
Automatika musí zaznamenať signál, vyžiadať zdroje, spustiť aplikáciu a pripraviť novú kapacitu na prácu. Dokumentácia Kubernetes opisuje HPA ako periodickú riadiacu slučku. Nereaguje okamžite. Iné platformy majú vlastné správanie; skutočné oneskorenie zmerajte vo svojom prostredí.
Pred známou kampaňou pripravte kapacitu včas. Skontrolujte zahriatie, databázové spojenia aj kvóty účtu a overte, že nové inštancie skutočne obsluhujú prevádzku. Pre nepredvídateľný rast nastavte signál súvisiaci s obmedzením, minimálnu a maximálnu kapacitu aj upozornenie pri dosiahnutí maxima.
Nezabudnite na cenu a znižovanie kapacity. Chybná úloha by nemala bez povšimnutia zvyšovať účet až k limitu poskytovateľa. Zmenšovanie kapacity nesmie prerušovať rozpracované úlohy alebo zahadzovať lokálny stav. Určte vlastníka pravidiel vrátane reakcie na chýbajúcu metriku či neúspešnú žiadosť o ďalšie zdroje.
09Vopred určte správanie pri preťažení
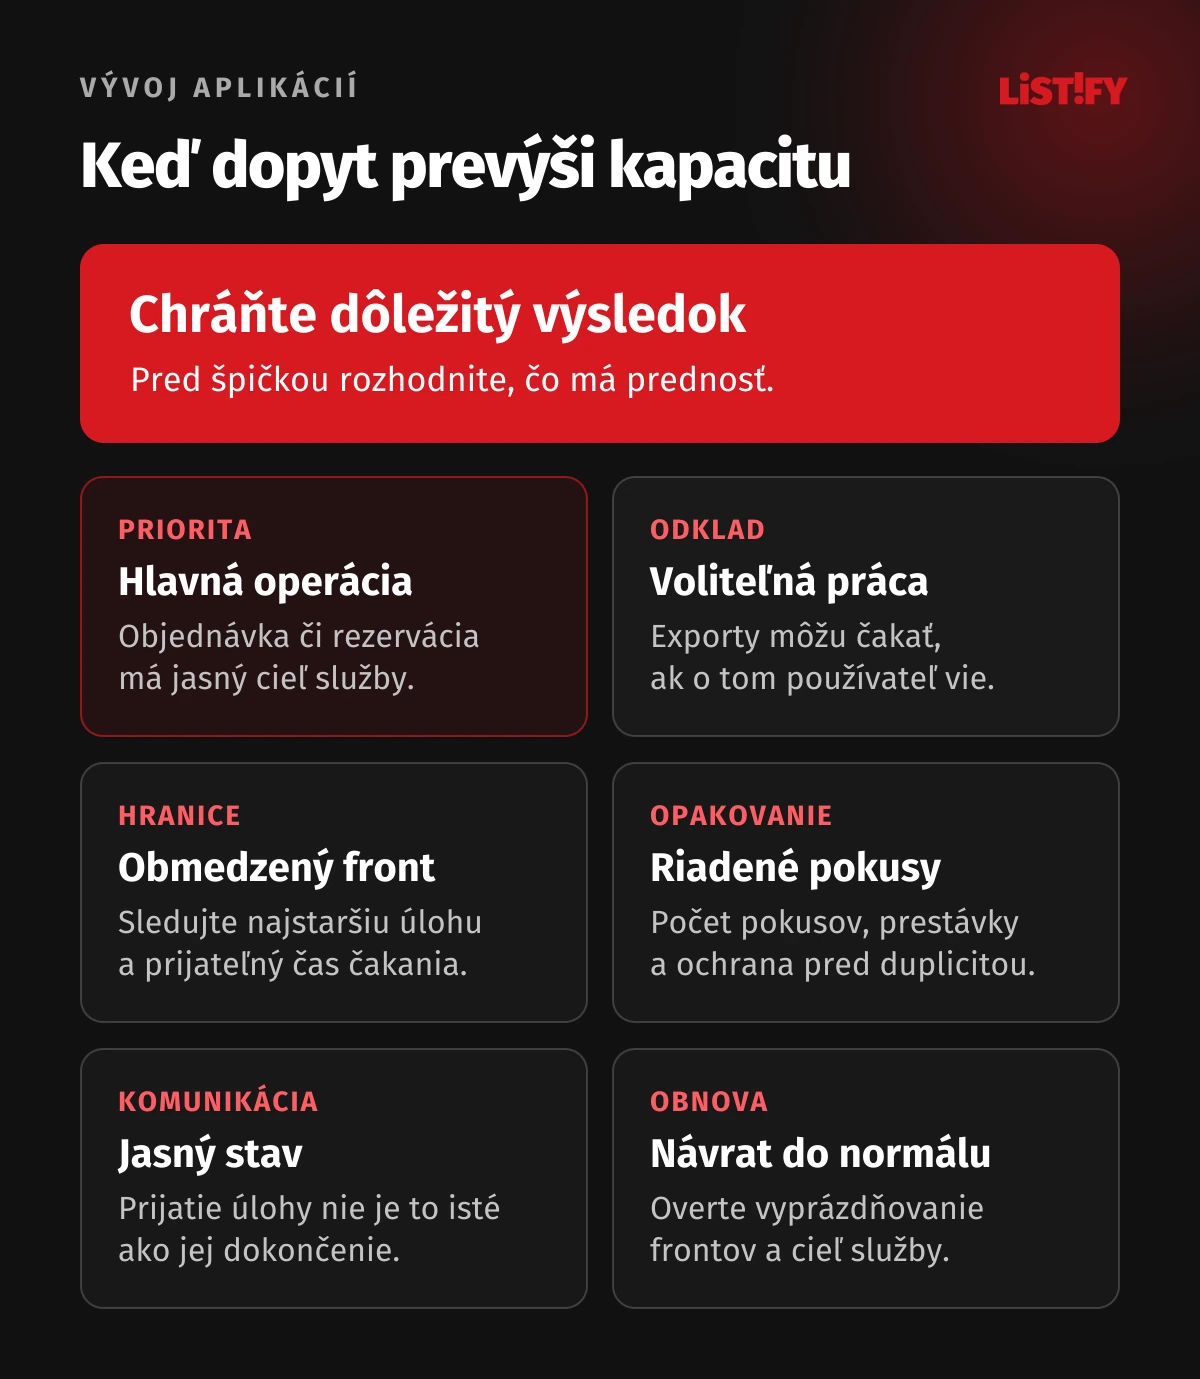
Aj dobrá predpoveď sa môže mýliť. Dohodnite, čo produkt urobí, keď už nemôže prijať ďalšiu prácu. Možno pozastaviť rozsiahle exporty, spomaliť hromadný import alebo zobraziť zrozumiteľné čakanie a ďalej chrániť hlavnú transakciu. Tento režim navrhnite a vyskúšajte pred rušným dňom.
Front potrebuje najvyšší prijateľný vek úlohy a postup pri neúspešnom spracovaní. Nie je nekonečnou rezervou. Google SRE vysvetľuje, ako rastúce fronty prehlbujú preťaženie. Sledujte dokončenú prácu a najstaršiu čakajúcu úlohu, nielen počet úspešne prijatých požiadaviek.
Kapacitu spotrebujú aj opakované pokusy. Obmedzte ich počet a nastavte vhodné prestávky; tam, kde hrozí duplicitný vedľajší účinok, použite idempotenciu. AWS pripomína, že uplynutie časového limitu nedokazuje nevykonanie pôvodnej operácie. Preťaženie nemá zákazníkovi vytvoriť dve rezervácie.
10Otestujte najbližšiu udalosť aj zvolenú poruchu
Najbližšiu obchodnú udalosť premeňte na zadanie testu. Opíšte priebeh príchodov, skladbu operácií, údaje, dĺžku záťaže a podmienky úspechu. Zahrňte súvislú špičku, pravdepodobný náraz aj zotavenie po poklese prevádzky. Sledujte vyprázdnenie frontov a návrat zdrojov do normálu, nie iba prvé dobre vyzerajúce minúty.
Generátor záťaže musí zodpovedať otázke. V uzavretom modeli simulovaný používateľ čaká na dokončenie práce a až potom začína ďalšiu. Otvorený model dokáže posielať nové príchody nezávisle. Dokumentácia k6 tento rozdiel opisuje podrobne. Ak v realite príchody pokračujú aj pri spomalení, samovoľné spomalenie testu môže tlak podhodnotiť.
V riadenom prostredí zopakujte relevantný scenár so zvolenou poruchou. Zaznamenajte plnenie cieľa, presun prevádzky aj obnovu. Úspešný výsledok platí pre overené podmienky. Je podkladom pre ďalšie rozhodnutie, nie trvalým certifikátom, že aplikácia zvládne ľubovoľne veľké publikum.
11Nasadenie zmeny musí mať brzdu a cestu späť
Ak to architektúra umožňuje, sprístupnite zmenu najprv obmedzenému publiku alebo podielu prevádzky. Porovnávajte rovnaké operácie pri podobnej záťaži. Okrem odozvy kontrolujte správnosť, chybovosť a náklady. Vyrovnávacia pamäť vracajúca údaje iného zákazníka je chybná zmena, aj keby všetky grafy ukazovali zrýchlenie.
Pred nasadením určte podmienku zastavenia: ktorý výsledok vedie k návratu, kto rozhodne a ako rýchlo môže zasiahnuť. Skontrolujte zlučiteľnosť s databázovou migráciou a rozpracovanými úlohami. Návrat k predchádzajúcej verzii kódu sám osebe nemusí vrátiť zmenené údaje ani schému.
Novú prevádzkovú hranicu zapíšte až po overení. Uchovajte predchádzajúce meranie, novú konfiguráciu a dôvod rozhodnutia. Krátky záznam zabráni tomu, aby niekto neskôr považoval odhad za otestovaný fakt. Vedenie zároveň uvidí, čo investícia skutočne priniesla a ktoré obmedzenie v systéme zostalo.
12Z kapacity urobte krátku pravidelnú poradu
Počas rýchleho rastu pomôže stručná týždenná kontrola prepojiť obchodné plány s prevádzkou. Agenda môže zostať rovnaká: skutočná špička oproti predpovedi, plnenie cieľa, zostávajúca rezerva, najbližšia udalosť a rozhodnutie, ktoré neznesie odklad. Pri stabilnom produkte interval predĺžte, ale ponechajte konkrétnu zodpovednú osobu.
Každej úlohe určte termín a spúšťač. „Preveriť import pred nástupom nového klienta“ sa dá splniť. „Zlepšiť škálovanie“ je želanie bez konca. Finančnému tímu ukážte bežné náklady, dočasnú cenu špičky aj prácu ľudí. Obchod potrebuje poctivo vedieť, akú kapacitu už máte overenú a čo musí ešte vzniknúť.
Potrebujete konkrétny technický plán? Začnite dôležitou operáciou, dostupným meraním a najbližšou obchodnou udalosťou. V rámci vývoja webových aplikácií môžeme prebrať rozsah projektu. Dobré zadanie požaduje podklady, priority a overiteľný výsledok, nie vopred vybraný nákup infraštruktúry.
13Časté otázky
Od koľkých používateľov treba aplikáciu škálovať?
Spoľahlivá hranica podľa počtu účtov neexistuje. Rozhoduje súbežná práca, náročnosť operácií, objem údajov a najvyťaženejší interval. Konajte, keď očakávaná záťaž približuje aplikáciu k využiteľnej kapacite pre dohodnutú kvalitu služby a výpadkový scenár.
Máme najprv posilniť databázu alebo aplikáciu?
Podľa nameraného obmedzenia. Čakanie na databázu, drahé dotazy a nedostatok spojení vyžadujú iný zásah než vyťažený procesor aplikácie. Pred objednaním upgradu overte vplyv na celý priechod požiadavky systémom.
Akú veľkú kapacitnú rezervu máme držať?
Takú, ktorá pokryje neistotu dopytu a zvolený výpadok pri zachovaní cieľa služby. Vychádzajte z realistického testu a času potrebného na pridanie zdrojov. Percento prevzaté od inej firmy kapacitný plán nenahradí.
Nahradí plán automatické škálovanie?
Nenahradí. Potrebuje vhodné signály, limity, dostupné zdroje aj čas na reakciu. Známe špičky pripravte vopred a overte celý reťazec vrátane databázy a externých služieb.
Potrebujeme na ďalší rast mikroslužby?
Nie automaticky. Najprv ukážte, ktorá časť nezvláda požadovanú záťaž a prečo nestačia jednoduchšie zmeny. Oddelenie časti systému dáva zmysel, ak prínos ospravedlní ďalšie nasadzovanie, monitoring a prevádzkovú prácu.
Ako často opakovať záťažový test?
Po významnej zmene záťaže, údajov, kódu, infraštruktúry alebo závislostí zopakujte príslušné scenáre. Test naplánujte aj pred dôležitým spustením. Interval má vychádzať z rizika a frekvencie zmien, nie z každoročnej povinnej kolónky.
Čo má technický tím odovzdať vedeniu?
Rozpätie očakávanej záťaže, využiteľnú kapacitu za opísaných podmienok, hlavné obmedzenie, odporúčaný zásah s nákladmi a zodpovednosťou a výsledok overenia. Súčasťou majú byť neistoty a podmienky, pri ktorých treba odporúčanie prehodnotiť.
14Zdroje a metodika
Technické zdroje overené 23. októbra 2026. Odporúčania tvoria redakčný postup na plánovanie prevádzky. Graf kapacity používa vymyslené vstupy na názorný výpočet; nejde o benchmark dodávateľa ani výsledok zákazníka LISTIFY. Nastavenia konkrétneho produktu overte podľa používanej verzie a prostredia.