Škálovatelnost webové aplikace: jak připravit systém na statisíce uživatelů
Webová aplikace zvládne statisíce uživatelů, když se nejdřív změří, kde je úzké hrdlo, a teprve potom se přidává výkon. Většinou to není slabý server, ale databáze, pomalá externí služba nebo tisíce lidí, kteří přijdou ve stejnou minutu. Projdeme to na výpadcích eDokladů, sčítání lidu a registrace k očkování i na tom, jak rostly Notion, Figma nebo Shopify. Na konci najdete plán, co řešit při 1 000, 10 000 a 100 000 uživatelích.
Pátek 3. října 2025, první den sněmovních voleb. Během prvních čtyř hodin zaznamenala aplikace eDoklady přes 1,5 milionu přihlášení přes NIA. Část aplikace, která aktualizuje digitální doklady, se přetížila a část voličů nemohla elektronický průkaz ve volební místnosti použít k prokázání totožnosti. Ředitel Digitální a informační agentury se omluvil a nabídl rezignaci.
Podobný příběh zná skoro každý, kdo spouštěl úspěšnou kampaň, prodej vstupenek nebo nový produkt. Dokud aplikaci používá pár stovek lidí, všechno běží. Pak přijde reklama v televizi, termín pro podání přiznání nebo zmínka v médiích a web, který v úterý fungoval, ve čtvrtek nenačte ani přihlášení.
Škálovatelnost je schopnost systému zvládnout víc uživatelů a dat, aniž by zpomalil nebo spadl. Pro statisíce uživatelů přitom nepotřebujete architekturu, jakou mají největší světové platformy. Potřebujete vědět, kde se vaše aplikace zlomí dřív, než to zjistí zákazníci.
01Krátká odpověď: co rozhoduje o tom, jestli aplikace nápor vydrží
| Oblast | Co se pod náporem typicky pokazí | Co pomáhá |
|---|---|---|
| Databáze | Pomalé dotazy bez indexů, stovky spojení najednou, jeden dotaz spouštěný tisíckrát | Indexy, pool spojení, mezipaměť, repliky pro čtení |
| Prudký náběh | Tisíce lidí ve stejné minutě, automatické škálování nestihne přidat výkon | Předem připravená kapacita, čekárna, rozložení termínů |
| Externí služby | SMS brána, platby nebo registr mají vlastní limity | Fronta, limity rychlosti, srozumitelná zpráva uživateli |
| Stav na serveru | Přihlášení a soubory uložené na jednom stroji, druhý server nejde přidat | Bezstavová aplikace, relace a soubory mimo server |
| Pomalé úlohy | Exporty, PDF a e-maily blokují odpověď uživateli | Úlohy na pozadí přes frontu |
| Měření | Nikdo neví, co je pomalé, dokud si nestěžují zákazníci | Monitoring odezvy a chyb, zátěžové testy před špičkou |
Škálovat jde dvěma směry. Vertikálně znamená dát aplikaci silnější server: víc procesorů a paměti. Je to rychlé a jednoduché, ale má to strop a jeden stroj zůstává jedním místem, kde může všechno selhat. Horizontálně znamená přidat další servery vedle sebe a rozdělit mezi ně práci. Strop je mnohem výš, aplikace na to ale musí být připravená.
Škálovatelnost také není totéž co rychlost. Aplikace může mít pro jednoho uživatele odezvu 50 milisekund a při tisíci současných uživatelích se zastavit. Nebo naopak: je trochu pomalejší, ale stejně pomalá při deseti i při deseti tisících lidí. Ta druhá je škálovatelná, první ne.
02Statisíce uživatelů neznamenají statisíce požadavků za sekundu
Když firma řekne „potřebujeme aplikaci pro 300 000 uživatelů“, většinou myslí registrované účty. Server ale nezajímá, kolik lidí má účet. Zajímá ho, kolik požadavků přijde v nejhorší sekundě. Hrubý odhad se dá spočítat za pět minut:
| Krok | Předpoklad | Výsledek |
|---|---|---|
| Registrovaní uživatelé | zadání | 300 000 |
| Aktivní za den | 20 % z registrovaných | 60 000 lidí |
| Nejvytíženější hodina | 15 % denní návštěvnosti | 9 000 lidí za hodinu |
| Požadavky na server | 30 za jednu návštěvu | 270 000 za hodinu |
| Průměr v nejvytíženější hodině | 270 000 / 3 600 s | 75 požadavků za sekundu |
| Krátká špička | 3× víc než průměr hodiny | přibližně 225 požadavků za sekundu |
Pro srovnání: Stack Overflow v roce 2016 podle svého inženýra Nicka Cravera obsloužil 209 milionů HTTP požadavků za den, v průměru přes 2 400 za sekundu. Zvládlo to 11 webových serverů (z toho 2 pro vývoj a meta) a 4 databázové servery SQL Server. Běžná firemní aplikace se statisíci účty je tedy zátěž, kterou dobře postavený systém unese na několika serverech.
Háček je ve slově „špička“. Průměr nic neříká o chvíli, kdy všichni přijdou naráz: v 8:00 při startu registrace, v neděli večer před termínem nebo po odvysílání reklamy. Právě tam padají i systémy, které jinak běží bez problémů.
03Kde se aplikace láme: čtyři české výpadky a jedno poučení
Veřejně popsané výpadky českých státních systémů jsou dobrá učebnice, protože se o nich psalo podrobně včetně technických příčin. Ve většině se ukázal stejný vzorec: příčinou nebyl celý systém, ale jedno konkrétní místo, se kterým se dopředu nepočítalo.
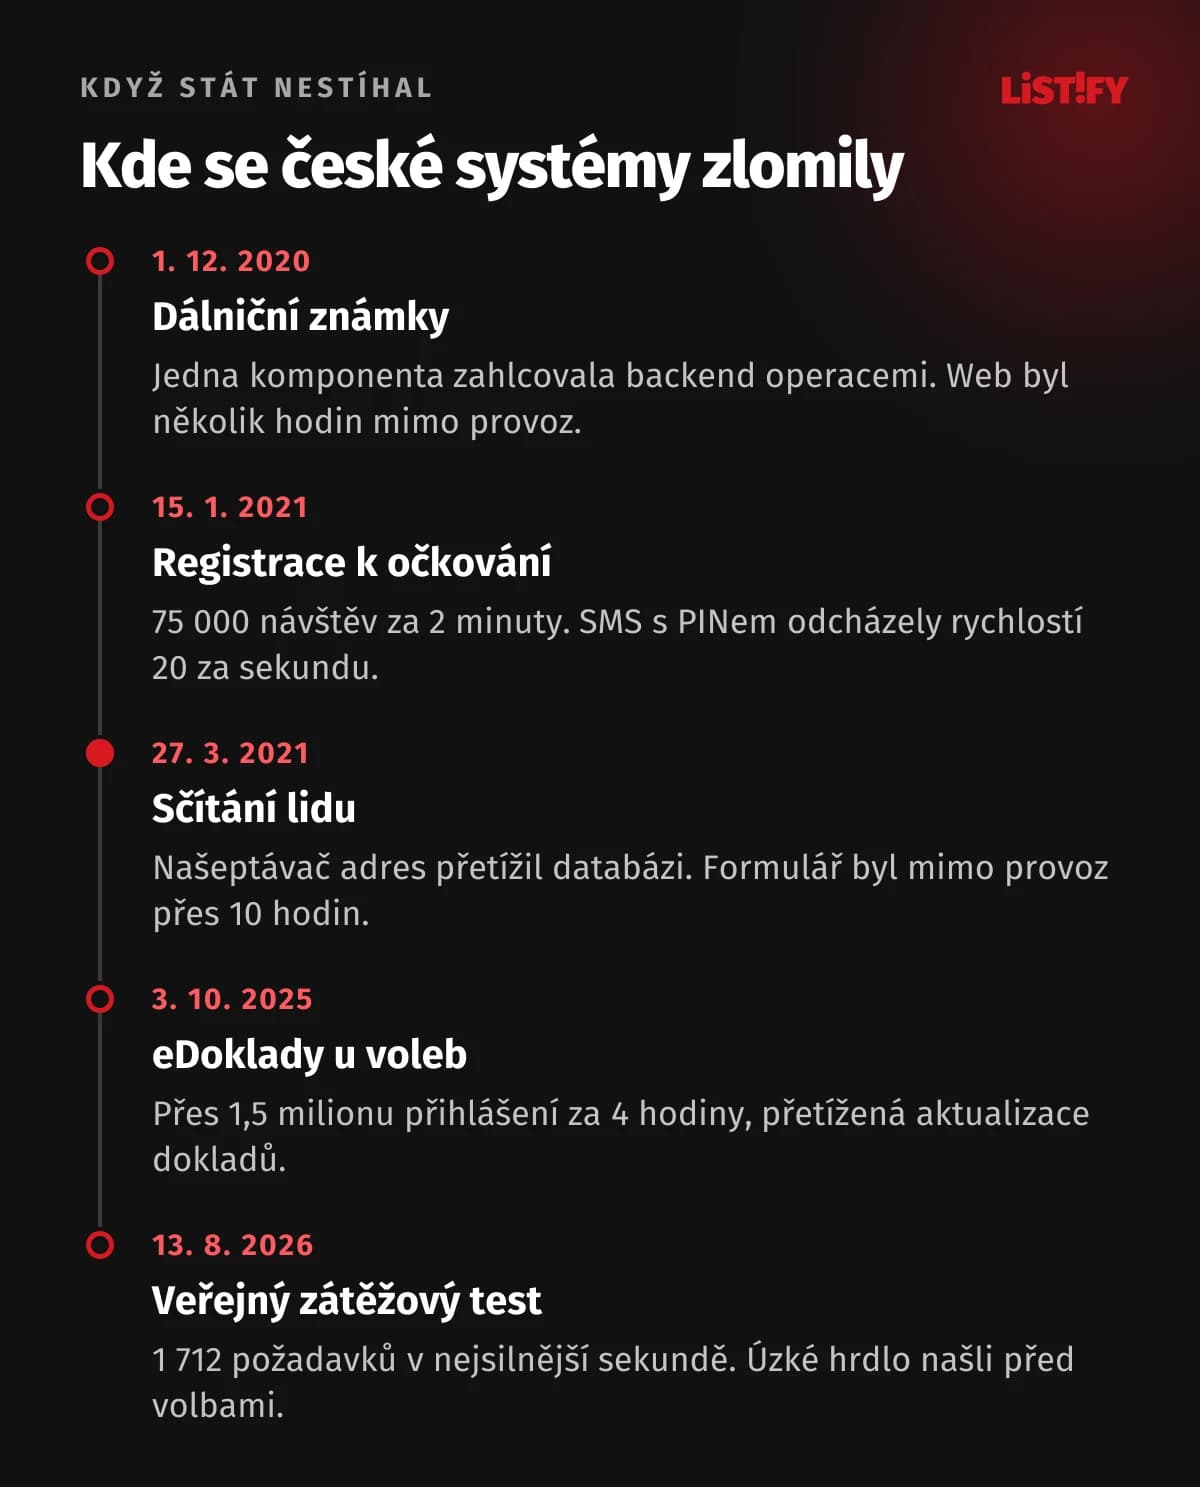
- E-shop dálničních známek, 1. 12. 2020. Web edalnice.cz byl první den několik hodin mimo provoz. Nejdřív se mluvilo o ochraně před útokem, šéf dodavatele CENDIS Jan Paroubek pak vysvětlil, že jedna komponenta generovala obrovské množství operací mezi frontendem a backendem, což se při testech neprojevilo. Systém podle Deníku stál 309 milionů korun.
- Registrace k očkování, 15. 1. 2021. Během prvních dvou minut přišlo 75 000 návštěv. Systém se zadrhával, hlavní úzké hrdlo ale nebylo v samotné aplikaci: PIN pro přihlášení chodil přes SMS a operátoři je rozesílali rychlostí 20 SMS za sekundu. Ve frontě jich čekalo přes 40 000. Kapacitu brány se podařilo zvýšit na 200 SMS za sekundu až o půl hodiny později.
- Sčítání lidu, 27. 3. 2021. Online formulář byl podle Lupy mimo provoz něco přes deset hodin. Příčinou podle dodavatele OKsystem byla závada v modulu pro vyplnění adres s našeptávačem, který přetížil databázové servery. Předseda ČSÚ uvedl, že chybu neodhalilo ani náročné testování včetně nezávislé firmy.
- eDoklady u voleb, 3. 10. 2025. Přes 1,5 milionu přihlášení za první čtyři hodiny a přetížená část pro aktualizaci dokladů. DIA přiznala nesprávný odhad zátěže a testování, ředitel uvedl, že zájem nepokryla kapacita systému, a agentura dodala, že tak koncentrovaný nápor v krátkém okně nešlo v tehdejších testovacích podmínkách plně nasimulovat.
V prvních třech případech nešlo jen o to, že by „bylo málo serverů“. Jednou komponenta zbytečně komunikovala se serverem, podruhé externí SMS brána měla svůj strop, potřetí jeden našeptávač vytížil databázi. Přidat hardware by tam pomohlo málo nebo vůbec. U eDokladů v roce 2025 kapacita chyběla, ale i tam šlo o jednu konkrétní část aplikace.
Finanční správa v dubnu 2026 předem varovala, že portál MOJE daně může být v posledních dnech a hodinách před termínem kvůli vysokému počtu přihlášení krátkodobě přetížen. I to je poctivý přístup ke škálování: když víte, že špička přijde, řekněte to lidem a rozložte ji.
04Co ukázal veřejný zátěžový test eDokladů
Digitální a informační agentura 13. srpna 2026 zkusila něco, co český stát dosud neudělal: pozvala veřejnost, aby se ve stejnou chvíli přihlásila do eDokladů. Zapojilo se 30 tisíc uživatelů a výsledky DIA zveřejnila včetně čísel, která firmy obvykle drží pro sebe.
Ve 13:00 vzrostl počet souběžných spojení na vstupní bráně během dvou minut téměř dvanáctkrát. V nejsilnější sekundě přišlo 1 712 požadavků. Aplikační servery to zvládaly: 95 % přihlášení vyřídily do 20 milisekund a serverových chyb bylo jen 0,06 %. Uživatelé v telefonech přesto čekali.
- Běžný provoz před testem (12:00 až 12:45)3,6
- Prudký náběh (13:00 až 13:10)33,5
- Rozložený náběh večer (od 19:15)4,3
Hodnoty v sekundách, odezva z pohledu telefonu uživatele (99. percentil). Zdroj: DIA, analýza veřejného testu eDokladů zveřejněná 18. 8. 2026.
Medián odezvy vyskočil z 28 na 267 milisekund, 95 % požadavků skončilo do 22,2 sekundy a 99 % až do 33,5 sekundy. Podle analýzy DIA nebyl omezením výkon aplikačních serverů ani objem dat. Rozhodla rychlost, s jakou vstupní brána Application Gateway dokázala přidávat kapacitu po skokovém nárůstu spojení.
Večerní vlna, která přišla spontánně během zpráv v 19:15, měla zhruba poloviční počet přihlášení (přes 14 tisíc) a podobný objem dat, jen rozložený do zhruba půl hodiny. Dopadla úplně jinak: medián 29 milisekund, 99 % požadavků do 4,3 sekundy a 0,05 % chyb. DIA proto před volbami zvýší připravenou kapacitu brány, aby při náhlém nárůstu nemusela škálovat ze základní úrovně.
Z testu plynou tři obecná poučení. Automatické škálování není okamžité a na ohlášenou špičku je lepší mít výkon připravený předem. Medián odezvy může vypadat skvěle, zatímco každý dvacátý požadavek čeká desítky sekund. A tvar náběhu je stejně důležitý jako počet lidí: tisíce lidí za dvě minuty jsou jiný problém než tytéž tisíce za hodinu.
05Kolik stojí výpadek a pomalá aplikace
Cenu výpadku si každá firma musí spočítat sama: ušlé objednávky za hodinu, práce podpory, slevy pro naštvané zákazníky, smluvní pokuty. Velké průzkumy ukazují spíš řád. Podle Uptime Institute (zpráva Annual Outage Analysis 2026) stál 57 % provozovatelů datových center jejich poslední velký výpadek víc než 100 000 USD a každého pátého víc než milion dolarů. Firma ITIC v průzkumu z roku 2024 uvádí, že u více než 90 % středních a velkých podniků stojí hodina výpadku přes 300 000 USD.
Na menší firmu se ta čísla nehodí, ITIC ale nabízí menší příklad: i firma, která hodinu výpadku odhadne na 10 000 USD, přichází o 167 USD za každou minutu. Často citované číslo „5 600 dolarů za minutu“ od Gartneru pochází z blogu analytika Andrewa Lernera z roku 2014, týká se výpadků sítě a podle jeho vlastních slov jde o průměr s velkým rozptylem.
U státních zakázek se cena píše přímo do smlouvy. Dodavatel aplikace pro sčítání měl podle smluv zveřejněných v registru opravit chybu s vysokou prioritou do 15 minut a za každou další čtvrthodinu zaplatit pokutu 20 000 korun.
Pomalost stojí peníze i bez výpadku
Studie Deloitte Milliseconds Make Millions z roku 2020, kterou zadal Google, sledovala 37 značek a 30 milionů návštěv. Při zrychlení mobilního webu o desetinu sekundy vzrostly konverze v maloobchodě o 8,4 % a v cestovním ruchu o 10,1 %. Jde o souvislost, ne o kontrolovaný pokus. Čistý experiment popsal Ronny Kohavi z Microsoftu: když vyhledávač Live Search zpomalil výsledky o sekundu, uživatelé položili o 1 % dotazů méně a na reklamy klikli o 1,5 % méně.
Slavné „Amazon ztrácí 1 % tržeb za každých 100 ms“ má jediný primární zdroj: řádek na slajdu bývalého inženýra Amazonu Grega Lindena z přednášky v roce 2006, bez popisu metodiky. Směr platí, přesné číslo pro dnešní web ne.
Česká data ukazují, že problém je tady a teď. Podle ČSÚ zaznamenalo v roce 2025 technické problémy při zadávání objednávky 20 % lidí, kteří v posledních třech měsících nakupovali na internetu. Jak rychlost a srozumitelnost ovlivňují, jestli se lidé do aplikace vracejí, rozebíráme v článku UX design webové aplikace.
06Databáze: obvykle první úzké hrdlo
Aplikační server se dá zkopírovat a spustit desetkrát. Databáze s daty, která musí být všude stejná, ne. Proto se mnoho aplikací pod zátěží zadrhne právě tady. Ukázal to i výpadek sčítání: jeden našeptávač adres posílal do databáze víc práce, než zvládla.
1. Indexy a pomalé dotazy
Dotaz, který na testovací databázi s tisícem řádků trvá milisekundu, může na milionu řádků trvat stovky milisekund i víc, protože databáze prochází celou tabulku. Než začnete kupovat výkonnější server, podívejte se, jak databáze dotaz provádí, a přidejte index na sloupce, podle kterých se hledá a řadí. V PostgreSQL to vypadá třeba takto:
EXPLAIN ANALYZE
SELECT id, total FROM orders
WHERE customer_id = 4821
ORDER BY created_at DESC
LIMIT 20;

CREATE INDEX CONCURRENTLY idx_orders_customer_created
  ON orders (customer_id, created_at DESC);
Častou chybou je také takzvaný problém N+1: aplikace načte seznam 50 objednávek a pak pro každou zvlášť dotazem dohledá zákazníka. Místo jednoho dotazu jich pošle 51. Při deseti uživatelích to nikdo nepozná, při deseti tisících to databázi položí.
2. Pool spojení
Každé spojení do databáze stojí paměť. PostgreSQL má ve výchozím nastavení limit obvykle 100 současných spojení a jeho zvýšení znamená víc sdílené paměti. Když aplikace běží na deseti serverech a každý si otevře 20 spojení, limit je pryč. Řešením je pool spojení, například PgBouncer, který v režimu transakcí přiděluje spojení jen na dobu jedné transakce. Wiki PostgreSQL k tomu výslovně píše, že méně spojení s frontou často obslouží víc současných uživatelů než mnoho spojení najednou.
3. Repliky pro čtení a rozdělení databáze
Většina aplikací data víc čte, než zapisuje. Kopie databáze určené jen pro čtení (repliky) převezmou přehledy, vyhledávání a reporty, hlavní databáze pak řeší zápisy. Repliky bývají o chvilku pozadu, takže údaj, který uživatel právě uložil, je lepší číst z hlavní databáze. Další krok je rozdělit data podle modulů do samostatných databází, například fakturaci zvlášť a zvlášť analytiku.
Až úplně nakonec přichází sharding, tedy rozdělení jedné velké tabulky mezi víc databázových serverů. Dá se to zvládnout, ale je to drahé. Notion podle svého blogu vydržel na jedné databázi PostgreSQL pět let a čtyři řády růstu, v roce 2021 přešel na 480 logických shardů na 32 databázích a v roce 2023 počet strojů ztrojnásobil na 96. Figma v roce 2020 běžela na jediné databázi PostgreSQL na největší instanci, jakou AWS nabízel. Než rozdělila první tabulku, sáhla po replikách, mezipaměti a vertikálním dělení a samotné rozdělení první tabulky jí trvalo zhruba devět měsíců.
Pro firmu, která čeká statisíce uživatelů, z toho plyne jednoduchá rada: vyberte spolehlivou relační databázi, navrhněte dobře tabulky a indexy a sharding neplánujte dopředu. Pokud se k němu jednou dostanete, bude to znamenat, že se produktu daří.
07Mezipaměť a CDN: nejlevnější výkon, jaký můžete mít
Nejrychlejší požadavek je ten, který k vaší aplikaci vůbec nedojde. Obrázky, skripty, styly a veřejné stránky může vydávat CDN, tedy síť serverů blízko uživatelů. Výsledky častých dotazů může aplikace držet v paměti, typicky v Redisu, a do databáze sahat, jen když v mezipaměti údaj chybí nebo vypršel.
Kolik práce umí okrajová vrstva převzít, naznačují čísla Shopify z Black Friday a Cyber Monday 2025. Ve špičce přišlo 489 milionů požadavků za minutu na okrajovou vrstvu (edge), zatímco aplikační servery vrcholily na něco přes 117 milionech, tedy zhruba na čtvrtině. Stack Overflow v roce 2016 provedl v Redisu zhruba 160 miliard operací měsíčně a žádná instance přitom nepřesáhla 2 % vytížení procesoru.
Mezipaměť má dvě pasti. První je zastaralá data: u ceny, skladové zásoby nebo stavu objednávky musíte přesně vědět, kdy se mezipaměť maže. Druhá je chvíle, kdy mezipaměť vyprší a tisíc požadavků najednou zamíří do databáze pro stejný údaj. Discord to řeší slučováním: když víc uživatelů chce ve stejnou chvíli stejný řádek, databáze dostane jen jeden dotaz.
08Bezstavová aplikace: podmínka pro přidávání serverů
Horizontální škálování funguje, jen když je jedno, na který server požadavek dorazí. Aplikační server si proto nesmí nic pamatovat jen u sebe:
- Přihlášení patří do podepsaného tokenu nebo do sdíleného úložiště relací.
- Nahrané soubory patří do objektového úložiště (S3 a podobné služby), disk serveru je jen dočasný.
- Plánované úlohy musí běžet jednou, ne na každém serveru zvlášť, jinak zákazník dostane stejný e-mail desetkrát.
- Konfigurace se načítá z proměnných prostředí, aby nový server naběhl bez ručního nastavování.
Když tohle platí, stačí před aplikaci postavit load balancer a servery přidávat podle zátěže. AWS to ve svých doporučeních pro spolehlivost shrnuje dvěma principy: nahradit jeden velký zdroj několika menšími, aby výpadek jednoho neohrozil celek, a přestat hádat kapacitu, tedy přidávat a ubírat výkon automaticky podle skutečné poptávky.
Test eDokladů ale ukázal, že automatické škálování potřebuje čas. Na známé špičky (start prodeje, kampaň, uzávěrka) proto nastavte vyšší minimum předem a automatiku nechte řešit jen to, co nečekáte.
09Fronty a čekárny: co nemusí proběhnout hned
Uživatel po kliknutí na „Odeslat objednávku“ potřebuje vědět, že objednávka prošla. Nepotřebuje čekat, než se vygeneruje PDF faktura, odešle e-mail a zapíše se záznam do účetního systému. To všechno může převzít fronta úloh a zpracovat to o pár sekund později na pozadí.
Fronta je zároveň ochrana před limity cizích služeb. Registrace k očkování v lednu 2021 narazila přesně na tohle: za první hodinu přišlo 44 tisíc registrací, ale SMS s PINem odcházely rychlostí 20 za sekundu a ve frontě jich čekalo přes 40 000. Fronta tam byla, chyběla předem sjednaná kapacita u operátorů a jasná zpráva uživateli. S ní je čekání nepříjemnost. Bez ní lidé klikají znovu a znovu a zátěž násobí.
U akcí, kde se očekává nápor v jednu chvíli (vstupenky, registrace, omezené termíny), pomáhá virtuální čekárna. Aplikace pustí dovnitř tolik lidí, kolik zvládne, a ostatním ukáže pořadí. Rezervační systém očkování to v lednu 2021 dělal hláškou, že kapacita je plně obsazena a další rezervace budou možné po obsloužení uživatelů před vámi. Ještě lepší je nápor vůbec nevytvořit: termíny uvolňovat postupně nebo po skupinách, ne všechny v 8:00.
Pokud aplikace komunikuje s dalšími systémy, přečtěte si i článek Propojení systémů přes API. Limity počtu dotazů, opakování a chyby na straně partnera tam rozebíráme podrobně.
10Monolit, nebo mikroslužby?
Mikroslužby rozdělí aplikaci na desítky samostatných částí, které se nasazují a škálují zvlášť. Velkým firmám se stovkami vývojářů to dává smysl. Malému týmu to často přinese hlavně víc práce s provozem.
Segment v roce 2018 popsal, jak sloučil přes 140 služeb pro doručování dat zpět do jedné. Předtím tři inženýři na plný úvazek trávili většinu času jen tím, aby systém vůbec běžel. Tým Amazon Prime Video v roce 2023 přestavěl jednu monitorovací službu z rozdrobené serverless architektury na jeden celek a snížil náklady na infrastrukturu o víc než 90 %. Obojí se týkalo jedné části firmy, ne celého produktu, ale ukazuje to, že rozdělení na víc služeb samo o sobě výkon nepřidá.
Instagram v roce 2016 psal o největším nasazení frameworku Django na světě a o více než 500 milionech uživatelů. Stack Overflow v témže roce uváděl, že celou jeho síť otázek a odpovědí by v nouzi obsloužil jediný webový server. Ani jeden z nich k tomu nepotřeboval rozdělit aplikaci na desítky drobných služeb.
Pro většinu firemních aplikací a SaaS produktů proto doporučujeme modulární monolit: jedna aplikace s jasně oddělenými moduly (uživatelé, objednávky, fakturace), které spolu mluví přes definovaná rozhraní. Když jednou začne jeden modul potřebovat vlastní škálování nebo vlastní tým, dá se vyčlenit. Obráceně to jde mnohem hůř.
Podobně je to s Kubernetes. Podle průzkumu CNCF ho v produkci provozuje 82 % těch, kdo používají kontejnery, jenže odpovídají hlavně lidé z komunity kolem cloud native technologií. Mezi všemi vývojáři v průzkumu Stack Overflow 2025 s ním intenzivně pracovalo 28,5 %. Pro aplikaci se statisíci uživatelů často stačí spravovaná platforma, na které se o servery starat nemusíte.
11Měření: bez něj škálujete naslepo
Než cokoli optimalizujete, potřebujete vidět, co se v aplikaci děje. Minimum pro produkční aplikaci:
- Odezva v percentilech. Průměr i medián skryjí problém. Sledujte medián, 95. a 99. percentil, tedy čas, do kterého dostane odpověď 95 a 99 požadavků ze sta. U eDokladů byl medián při prudkém náběhu 267 milisekund, ale 99. percentil 33,5 sekundy.
- Podíl chyb. Kolik požadavků skončí chybou serveru, rozdělené podle částí aplikace.
- Vytížení zdrojů. Procesor, paměť, počet spojení do databáze, délka fronty úloh.
- Nejpomalejší dotazy do databáze. PostgreSQL je umí logovat sám.
- Upozornění. Když něco překročí limit, musí se to dozvědět někdo z týmu dřív, než zavolá zákazník.
Druhá věc je dohodnout se, jak spolehlivá aplikace má být. Google ve své knize o provozu (Site Reliability Engineering) doporučuje stanovit cíl dostupnosti a z něj odvodit rozpočet chyb: kolik výpadků si můžete dovolit, než zastavíte nové funkce a začnete opravovat. Služba, která za den obslouží 2,5 milionu požadavků s cílem 99,99 %, může vrátit nejvýš 250 chyb.
- 99 %432,0
- 99,5 %216,0
- 99,9 %43,2
- 99,95 %21,6
- 99,99 %4,3
Minuty za 30denní měsíc, výpočet podle tabulky dostupnosti v knize Google SRE. Za rok znamená 99,9 % zhruba 8,8 hodiny výpadku.
Každá devítka navíc stojí peníze: záložní servery, druhé datové centrum, lidi v pohotovosti. Google sám upozorňuje, že uživatel na telefonu s 99% spolehlivostí rozdíl mezi 99,99 % a 99,999 % nepozná. Pro firemní aplikaci je 99,9 % rozumný start, pro platby a zdravotnictví víc.
12Zátěžové testy: jak je udělat, aby měly smysl
Zátěžový test webové aplikace simuluje návštěvníky a měří, kdy se systém začne zpomalovat a kdy padá. Nástroj k6 od Grafany rozlišuje šest typů testů: kouřový (smoke) ověří, že test vůbec funguje, test průměrné zátěže běžný provoz, stresový test zátěž nad průměrem, dlouhodobý (soak) chování po hodinách, test špičky (spike) náhlý nápor a test bodu zlomu hledá, kde je strop.
Takhle vypadá jednoduchý test špičky: dvě minuty pozvolný náběh na 50 uživatelů, pak během 30 sekund 2 000 virtuálních uživatelů a pět minut plné zátěže. Test neprojde, pokud selže 1 % požadavků nebo víc, 95. percentil odezvy přesáhne 800 milisekund nebo 99. percentil dvě sekundy.
import http from 'k6/http';
import { sleep } from 'k6';

export const options = {
  stages: [
    { duration: '2m', target: 50 },
    { duration: '30s', target: 2000 },
    { duration: '5m', target: 2000 },
    { duration: '1m', target: 0 },
  ],
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<800', 'p(99)<2000'],
  },
};

export default function () {
  http.get('https://test.vase-aplikace.cz/api/terminy');
  sleep(1);
}
Aby test něco odhalil, musí co nejvíc připomínat realitu:
- Testujte celou cestu uživatele, ne jednu stránku. Sčítání spadlo na našeptávači adres, tedy na části, kterou jednoduchý test přihlášení nezachytí.
- Použijte data v produkční velikosti. Dotaz nad prázdnou databází je vždy rychlý.
- Zkoušejte i prudký náběh, nejen pomalé přidávání uživatelů. Test eDokladů ukázal, že podobný objem provozu rozložený do půl hodiny je úplně jiná situace.
- Zahrňte externí služby nebo jejich věrnou náhradu a zjistěte si jejich limity. Platební brána, SMS a registry mají svůj strop.
- Test zopakujte po každé větší změně a před každou ohlášenou akcí. Shopify před Black Friday 2025 provedl od dubna do října pět velkých testů a ve čtvrtém dosáhl 146 milionů požadavků za minutu.
Nikdy netestujte produkci bez domluvy s poskytovatelem hostingu. Zátěžový test ze stovek strojů vypadá jako útok a může skončit zablokováním.
13Cloud, nebo vlastní server: kolik stojí výkon
Placený cloud používalo podle Eurostatu v roce 2025 54,9 % českých firem s deseti a více zaměstnanci, víc než průměr EU. Většinou jde ale o e-mail a kancelářské programy. Za výpočetní výkon pro vlastní aplikace platilo jen 13,2 % firem.
- FinskoJakýkoli placený cloud: 79,2 %Výkon pro vlastní aplikace: 22,0 %
- ŠvédskoJakýkoli placený cloud: 72,0 %Výkon pro vlastní aplikace: 29,3 %
- NizozemskoJakýkoli placený cloud: 68,5 %Výkon pro vlastní aplikace: 26,3 %
- ČeskoJakýkoli placený cloud: 54,9 %Výkon pro vlastní aplikace: 13,2 %
- NěmeckoJakýkoli placený cloud: 53,9 %Výkon pro vlastní aplikace: 15,8 %
- Průměr EUJakýkoli placený cloud: 52,7 %Výkon pro vlastní aplikace: 14,9 %
- RakouskoJakýkoli placený cloud: 52,1 %Výkon pro vlastní aplikace: 15,1 %
- SlovenskoJakýkoli placený cloud: 36,4 %Výkon pro vlastní aplikace: 9,8 %
Podíl firem s 10 a více zaměstnanci. Druhá řada: cloudový výpočetní výkon pro provoz vlastního softwaru. Zdroj: Eurostat, isoc_cicce_use (ukazatele E_CC a E_CC_PCPU).
Samotný server je překvapivě levná položka. Srovnání strojů se 2 procesorovými jádry a 8 GB paměti ukazuje, že i v cloudu AWS stojí jeden takový server v přepočtu do dvou tisíc korun měsíčně:
- Hetzner CCX13 (vyhrazená vCPU)1 047
- VEDOS VPS ON (2 vyhrazená vlákna, 80 GB)1 064
- AWS m7g.large, Frankfurt1 525
- AWS m7i.large, Frankfurt1 883
Ceníky k 25. až 28. 9. 2026, přepočet kurzem ČNB z 25. 9. 2026 (24,350 Kč/€, 21,359 Kč/USD). AWS bez disku a přenosu dat, 730 hodin. Hetzner zdražil 15. 6. 2026 (CCX13 z 15,99 na 42,99 €). Výkon „vlákna“ a „vCPU“ se přesně nerovná.
Skutečné náklady tvoří spravovaná databáze, přenosy dat, zálohy, monitoring a hlavně čas lidí, kteří se o provoz starají. Podle zprávy Flexera 2026 firmy odhadují, že 29 % výdajů na cloud utratí zbytečně. Opačným příkladem je 37signals (Basecamp, HEY), která přesunula aplikace z cloudu na vlastní servery a roční účet za cloud snížila z 3,2 milionu na 1,3 milionu dolarů. Její spoluzakladatel David Heinemeier Hansson ale sám píše, že cloud dává smysl na začátku a u velkých výkyvů zátěže.
Praktické pravidlo: dokud produkt hledá zákazníky, plaťte za spravované služby a šetřete čas vývojářů. Když máte stabilní a předvídatelný provoz a účet za cloud začne být významná položka, spočítejte si přechod na pronajaté nebo vlastní servery. O plánování rozpočtu a nákladů na provoz píšeme v článku Jak naplánovat vývoj SaaS aplikace.
14Plán podle fází: co řešit při 1 000, 10 000 a 100 000 uživatelích
Jde o naše doporučení z praxe. Hranice jsou orientační a počítají aktivní uživatele za den, ne registrované účty. Aplikace pro rezervace s ranní špičkou se může dostat do vyšší fáze dřív než interní systém s rovnoměrným provozem.
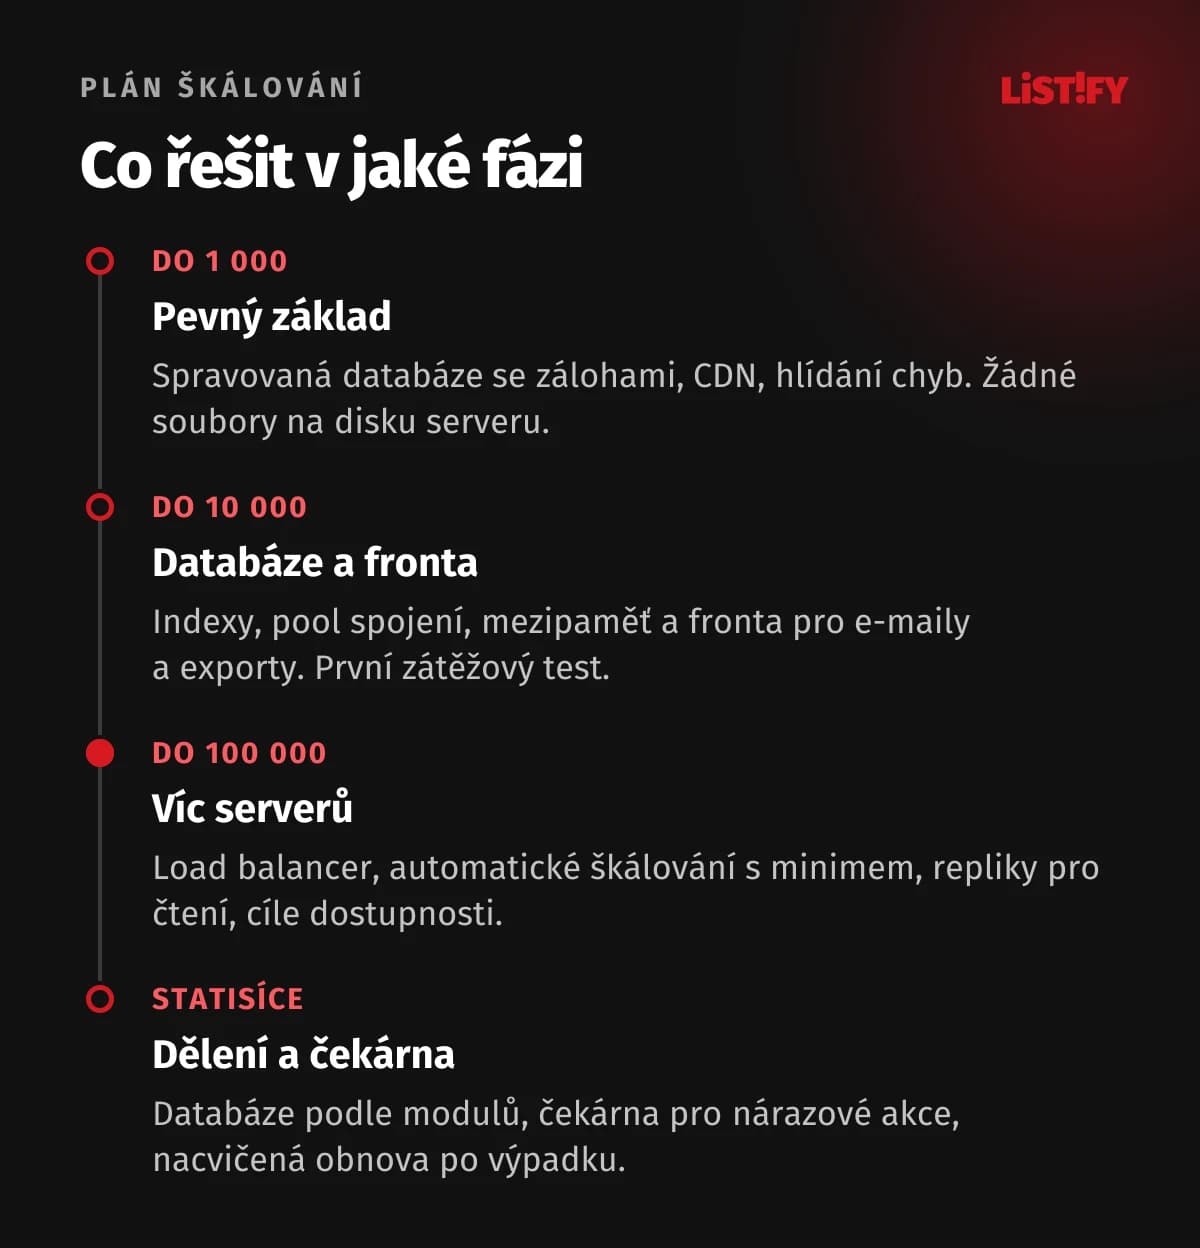
- Do 1 000 aktivních uživatelů denně. Jedna aplikace, spravovaná databáze s automatickými zálohami, CDN pro statické soubory, hlídání chyb a základní měření odezvy. Hlavně nezavírat si cestu: žádné soubory a relace na disku serveru.
- Do 10 000. Projít nejpomalejší dotazy a doplnit indexy, zapnout pool spojení, přidat mezipaměť pro nejčastější data a frontu pro e-maily, exporty a PDF. První zátěžový test s realistickými daty.
- Do 100 000. Víc instancí aplikace za load balancerem, automatické škálování s rozumným minimem, repliky databáze pro čtení, cíle dostupnosti a rozpočet chyb. Zátěžový test před každou větší akcí včetně prudkého náběhu.
- Statisíce a víc. Rozdělení databáze podle modulů, čekárna pro nárazové akce, oddělení kritických částí (přihlášení, platby) od zbytku, nacvičená obnova po výpadku. Sharding nebo samostatné služby jen tam, kde to měření opravdu ukáže.
Nejdražší varianta je přeskočit fáze oběma směry: postavit pro první stovku zákazníků složitý systém z mikroslužeb, nebo naopak ignorovat první tři body a řešit je až uprostřed kampaně.
15Jak zjistit, jestli je vaše aplikace připravená
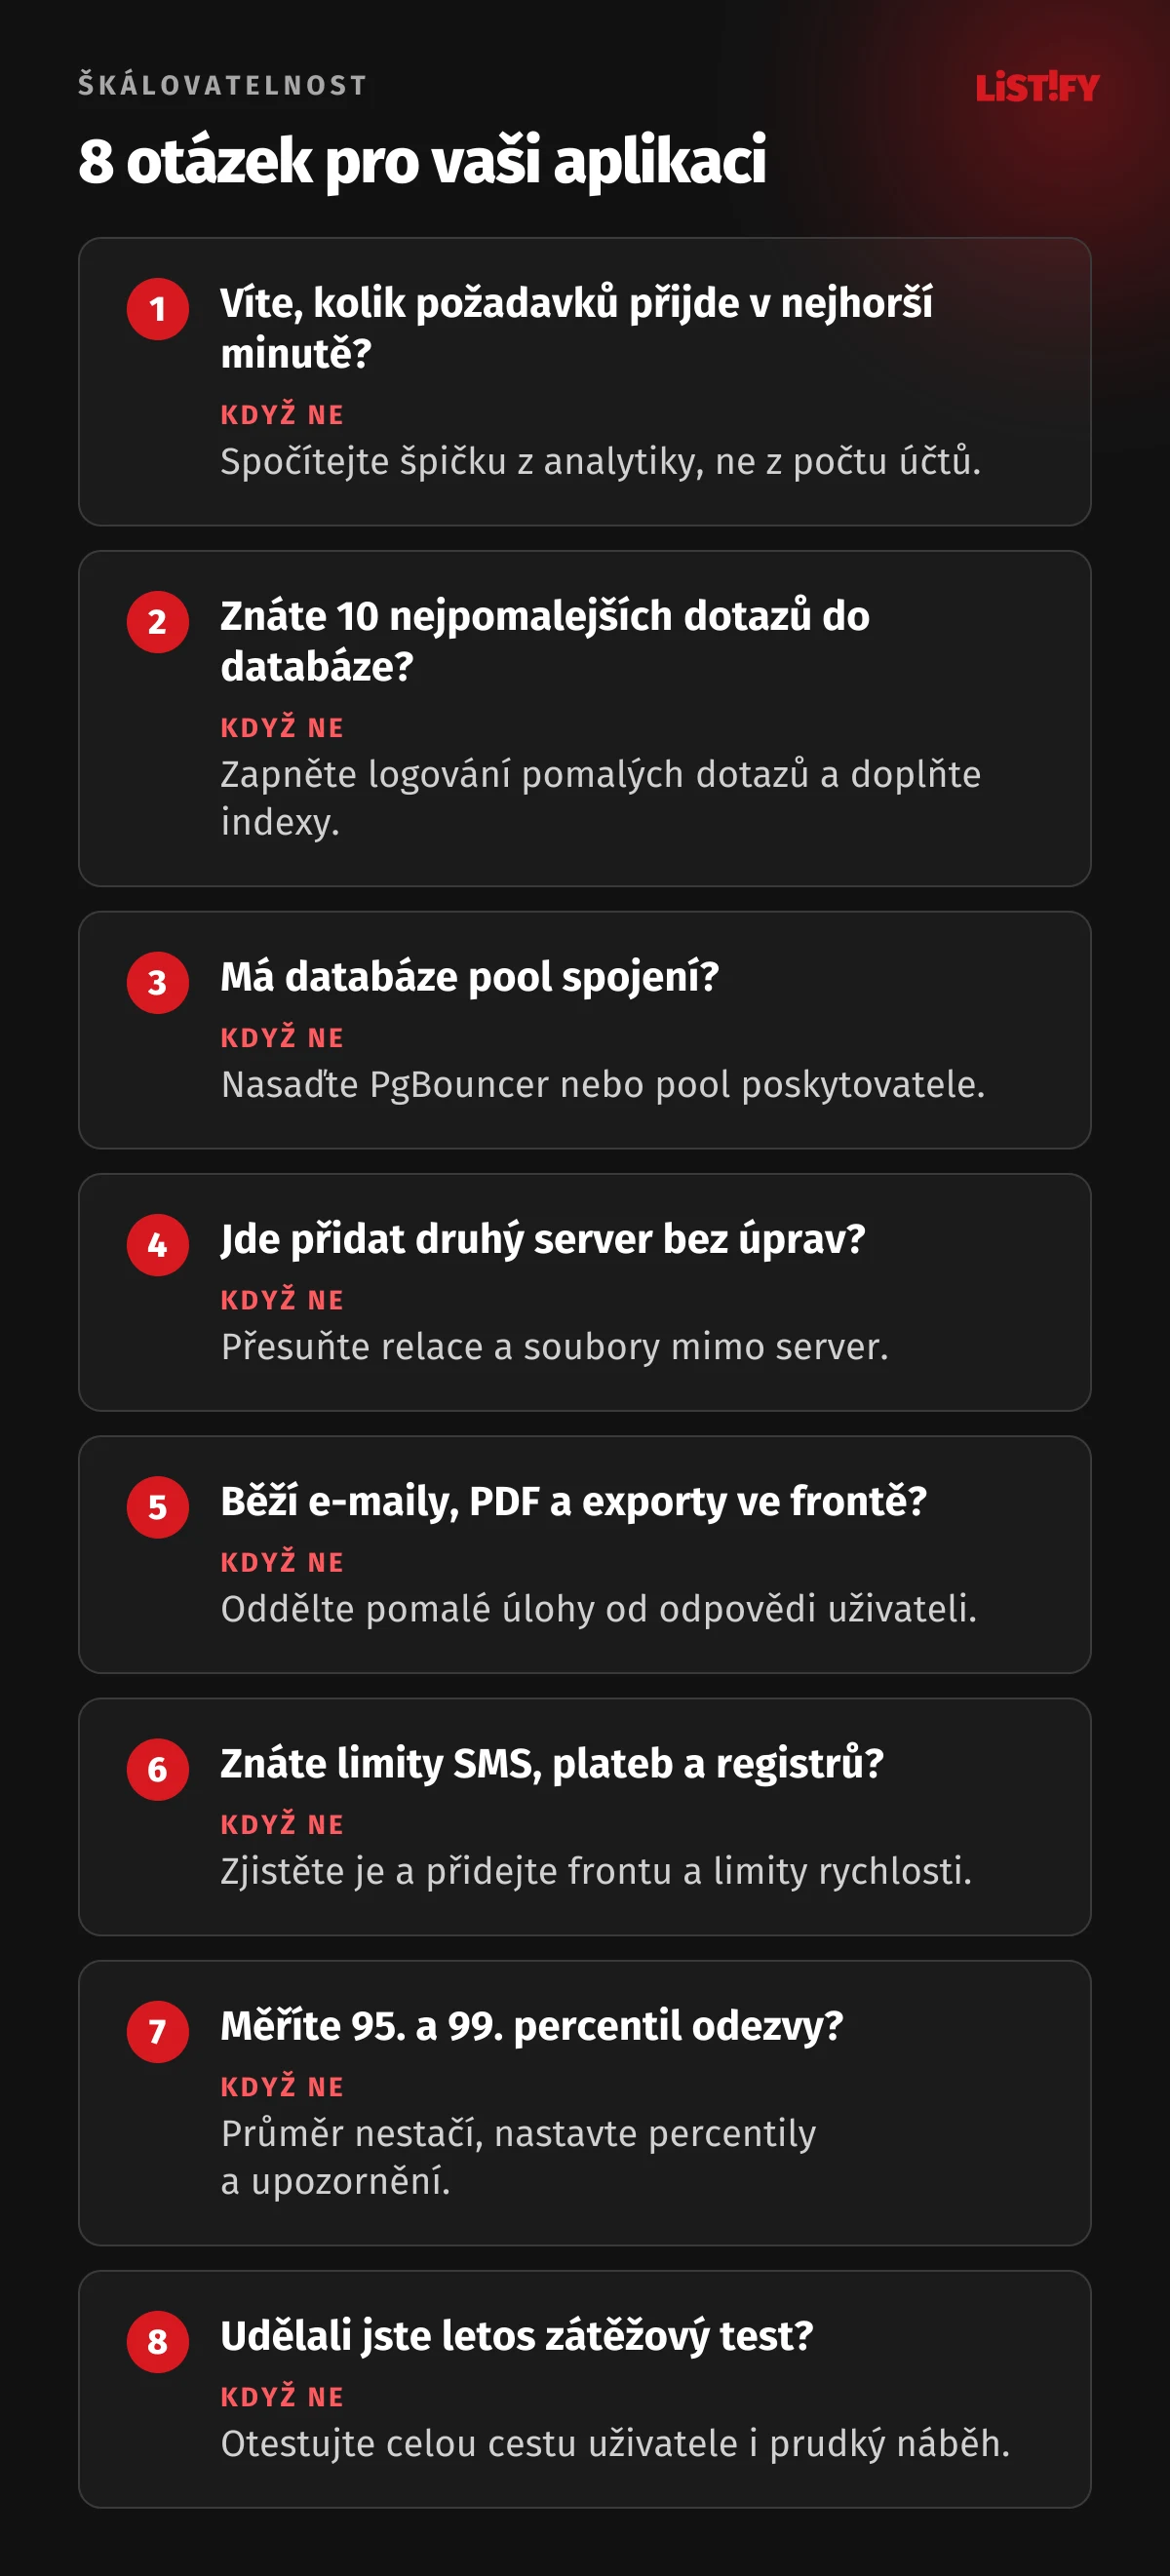
Než utratíte peníze za silnější servery, projděte si osm otázek. Každé „nevím“ je úkol pro vývojáře:
U nových projektů je nejlevnější myslet na tyto body od začátku. Návrh architektury, zátěžové testy a monitoring jsou u webových aplikací, které stavíme, součástí vývoje a neplatíte za ně navíc. Jak projekt probíhá, najdete na stránce Jak to probíhá, orientační ceny v ceníku.
Škálování se týká i bezpečnosti: s počtem uživatelů roste i to, co je v databázi v sázce. Na co myslet, popisuje článek Bezpečnost dat v systému na míru.
16Nejčastější chyby při škálování
- Kupovat výkonnější server dřív, než víte, co je pomalé. Pomůže na týden, pak se problém vrátí větší.
- Testovat jen přihlášení a úvodní stránku. Aplikace padají na konkrétních funkcích: našeptávač, export, vyhledávání.
- Testovat nad prázdnou databází. Výsledek bude skvělý a k ničemu.
- Spoléhat na automatické škálování u ohlášené špičky. Výkon potřebuje minuty na náběh, lidé vydrží čekat jen pár sekund.
- Ignorovat limity cizích služeb. SMS brána, platby nebo registry zastaví i aplikaci, která by jinak vydržela.
- Sledovat jen průměrnou odezvu nebo medián. Medián vypadá dobře, i když každý dvacátý požadavek čeká desítky sekund.
- Začít s mikroslužbami kvůli budoucímu růstu. Malý tým pak víc času stráví provozem než produktem.
- Pustit všechny lidi v jednu chvíli. Termíny, slevy a registrace jde často rozložit a problém tím zmizí.
17Časté otázky
Co je škálovatelnost webové aplikace?
Schopnost aplikace zvládnout víc uživatelů, požadavků a dat bez výrazného zpomalení a výpadků. Škálovat jde vertikálně (silnější server) nebo horizontálně (víc serverů vedle sebe). Horizontální škálování má vyšší strop, ale aplikace na něj musí být připravená.
Kolik serverů potřebuje aplikace se 100 000 uživateli?
Záleží na tom, kolik z nich je aktivních současně a co v aplikaci dělají. Podle našeho modelového výpočtu má aplikace se 100 000 registrovanými účty v běžné špičce spíš desítky až nízké stovky požadavků za sekundu, což obvykle zvládne několik aplikačních serverů a jedna dobře nastavená databáze. Spočítejte si špičku podle vzorce v článku a ověřte ji zátěžovým testem.
Potřebuji pro škálovatelnost mikroslužby?
Většinou ne. Pro menší a střední týmy je rozumnější modulární monolit, tedy jedna aplikace s oddělenými moduly. Segment i tým Amazon Prime Video popsaly, jak sloučením služeb ušetřily práci nebo peníze. Samostatné služby dávají smysl, když některá část potřebuje výrazně jiné škálování nebo vlastní tým.
Co je zátěžový test webu a kolik stojí?
Zátěžový test simuluje tisíce návštěvníků a měří, kdy se aplikace zpomalí nebo začne vracet chyby. Nástroje jako k6 nebo JMeter jsou zdarma, platíte hlavně čas na přípravu realistického scénáře a testovacích dat. Test by měl projít celou cestu uživatele až po odeslání objednávky nebo formuláře.
Jak poznám, že aplikace přestává stačit?
Roste 95. a 99. percentil odezvy, přibývá chyb serveru, databáze se blíží limitu spojení nebo vytížení procesoru a fronta úloh se nestíhá vyprazdňovat. Když tyto hodnoty neměříte, zjistíte to až od zákazníků.
Je cloud vždycky dražší než vlastní server?
Ne vždy, i když za stejný výkon bývá dražší. Na oplátku šetří práci se správou a umí rychle přidat výkon. Firma 37signals po přesunu na vlastní servery snížila roční účet za cloud z 3,2 na 1,3 milionu dolarů, sama ale píše, že cloud dává smysl na začátku a u velkých výkyvů zátěže. Rozhoduje stabilita provozu a čas vašeho týmu.
Jakou dostupnost má mít firemní aplikace?
Pro většinu firemních aplikací je rozumný cíl 99,9 %, tedy zhruba 43 minut výpadku za měsíc. Vyšší dostupnost vyžaduje záložní infrastrukturu a pohotovost, takže je výrazně dražší. Cíl stanovte podle toho, kolik vás hodina výpadku skutečně stojí.
18Zdroje
- DIA: Analýza veřejného testu eDokladů (18. 8. 2026)
- DIA: eDoklady u voleb, zkušenosti, poučení a další kroky (7. 10. 2025)
- Lupa.cz: Sčítání lidu 2021 začalo, online formulář je nedostupný
- Lupa.cz: Rezervační systém pro očkování, 75 tisíc lidí v prvních minutách
- Lupa.cz: Začal prodej elektronických dálničních známek a Aktuálně.cz o příčině výpadku
- Finanční správa: Krátí se čas na podání daňového přiznání (2026)
- ČSÚ: Využívání ICT v domácnostech a mezi jednotlivci 2025 (PDF)
- Eurostat: Cloud computing services by size class of enterprise (isoc_cicce_use)
- Uptime Institute: Annual Outage Analysis 2026
- ITIC: 2024 Hourly Cost of Downtime a část 2
- Deloitte a Google: Milliseconds Make Millions (PDF, 2020)
- Kohavi a kol.: Controlled experiments on the web (PDF, 2009)
- Nick Craver: Stack Overflow, The Architecture, 2016 Edition
- Notion: Herding elephants, sharding Postgres at Notion a The Great Re-shard
- Figma: How Figma’s databases team lived to tell the scale
- Discord: How Discord stores trillions of messages
- Shopify: výsledky Black Friday Cyber Monday 2025 a příprava na BFCM 2025
- Segment: Goodbye Microservices (2018)
- Amazon Prime Video: snížení nákladů o 90 % (archiv, 2023)
- PostgreSQL: Connections and Authentication a PgBouncer: Features
- AWS Well-Architected: Reliability pillar, design principles
- Google SRE: Availability table a Embracing risk
- Grafana k6: Load test types
- Flexera: State of the Cloud 2026 a CNCF Annual Cloud Native Survey 2025
- 37signals: Our cloud exit savings will now top ten million over five years
- Hetzner: úprava cen 2026, VEDOS VPS ON, AWS EC2 On-Demand